


云原生实时开发的资源底座:YARN 与 Kubernetes 双调度怎么选
一、从“调度选型”看大数据平台架构演进 在实时数据开发平台的架构设计中,“资源调度器用什么”看似是一个局部技术决策,实则牵动着整个平台的存储模型、部署方式、运维体系乃至成本结构。当前主流的实时计算引擎(如Flink、Spark)既支持部署在

一、从“调度选型”看大数据平台架构演进
在实时数据开发平台的架构设计中,“资源调度器用什么”看似是一个局部技术决策,实则牵动着整个平台的存储模型、部署方式、运维体系乃至成本结构。当前主流的实时计算引擎(如Flink、Spark)既支持部署在传统的YARN之上,也支持运行于Kubernetes集群。这一“双栈”局面的存在本身便说明:两种调度方案各有其不可替代的适用场景。
问题的关键不在于判断“谁更好”,而在于厘清YARN+HDFS与Kubernetes+对象存储两种组合形态各自解决了什么问题、适用于什么场景,以及企业应如何根据自身阶段做出合理选择。本文从这一小决策点切入,尝试给出一个结构化的分析框架。
二、YARN 的成熟度 vs K8s 的弹性
YARN是Hadoop 2.x引入的资源管理层,其设计假设是“长期集群+固定节点+Container隔离”。ResourceManager作为中心调度器维护全局资源状态,NodeManager管理单节点容器,ApplicationMaster代表作业向RM申请资源。这套机制经过多年大规模生产验证,在多租户队列隔离、资源抢占、数据本地性感知等方面积累了深厚的成熟度。对于以批处理为主、已有稳定Hadoop集群的团队,YARN仍是最低风险的选择。
Kubernetes则代表了另一种设计哲学——将一切工作负载容器化,通过声明式API和控制器模式实现自动化运维。kube-scheduler按Pod逐个调度,天然支持弹性伸缩(HPA/VPA)、GPU调度和服务发现。然而,原生K8s调度器在大数据场景下存在明显短板:缺乏gang scheduling语义(Spark的多个Executor Pod必须同时就绪才能启动作业,否则形成死锁)、没有作业级队列公平机制、抢占只能靠粗粒度的PriorityClass。这些短板通常需要引入Volcano或YuniKorn等补充调度器来解决。
抢占机制的差异同样值得关注:YARN是队列级抢占,按策略从超额队列回收资源;K8s是Pod级驱逐,可能直接杀掉任意低优先级Pod。两者对作业的影响面完全不同——前者保障的是队列间的公平,后者保障的是节点资源的可用性。
三、HDFS 的绑定 vs 对象存储的解耦
调度器的选择从来不是孤立的——它天然与存储架构绑定。
YARN+HDFS构成了一套“存算一体”的经典组合。HDFS的设计将计算与存储部署在同一批节点上,通过数据本地性实现高吞吐。但这种耦合也带来了刚性:集群规模必须同时满足计算和存储的需求,扩缩容不灵活;NameNode存在单点风险,小文件问题突出。
Kubernetes+对象存储(S3/OSS等) 则代表“存算分离”的云原生范式。对象存储作为托管服务提供近乎无限的容量和11个9的持久性,计算集群可以按需弹性扩缩,无需承担存储责任。这一组合彻底解耦了存储与计算——各自独立扩容、独立计费、独立运维。
然而,解耦并非没有代价。对象存储的API延迟(~50ms)高于HDFS的本地读延迟(~10ms),元数据操作更慢。对于低延迟随机访问敏感的业务,对象存储替代HDFS仍需审慎评估。
四、从场景出发,而非从技术偏好出发
综合上述对比,选型决策应基于以下维度判断:
优先选择YARN+HDFS的场景:
(1)已有稳定的Hadoop集群,团队具备YARN运维经验;
(2)作业以批处理为主,对数据本地性敏感;
(3)需要成熟的多租户队列管理和资源抢占机制;
(4)稳态高利用率场景——YARN的队列模型和资源预留机制在集群长期接近满载时比K8s的尽力调度模型更可预测。
优先选择Kubernetes+对象存储的场景:
(1)正在建设云原生平台,需要弹性扩缩容和GPU调度;
(2)需要与微服务、AI训练等非大数据负载混部;
(3)希望实现存算分离,降低存储成本;
(4)作业高峰低谷明显,需要按需使用计算资源。
需要指出的是,YARN不会很快消失,Kubernetes也并非万能。正如业内观察所言:“K8s是未来,但YARN还没死(特别是在老牌企业大数据平台)”。对于大多数企业而言,更现实的路径是渐进式演进——从YARN平稳过渡到双栈并存,再视情况逐步向K8s倾斜。
五、袋鼠云实时开发平台的双栈实践
袋鼠云实时开发StreamWorks是云原生一站式大数据实时开发平台,以Flink作为计算底座,同时支持基于YARN和Kubernetes进行资源调度。平台覆盖从实时数据采集、实时数据处理到任务运维监控的全链路。
这一双栈设计并非简单的“两个选项”堆叠,而是对上述选型逻辑的产品化回应:
- 对YARN的支持确保了存量Hadoop客户的平滑接入——无需改造现有集群架构即可获得平台能力;
- 对Kubernetes的支持则为云原生新建场景提供了弹性扩缩、容器化部署、GPU混合调度等现代化能力;
- 平台层面的统一抽象,使得用户无需在两种调度体系之间“二选一”即可完成实时数据开发全链路。
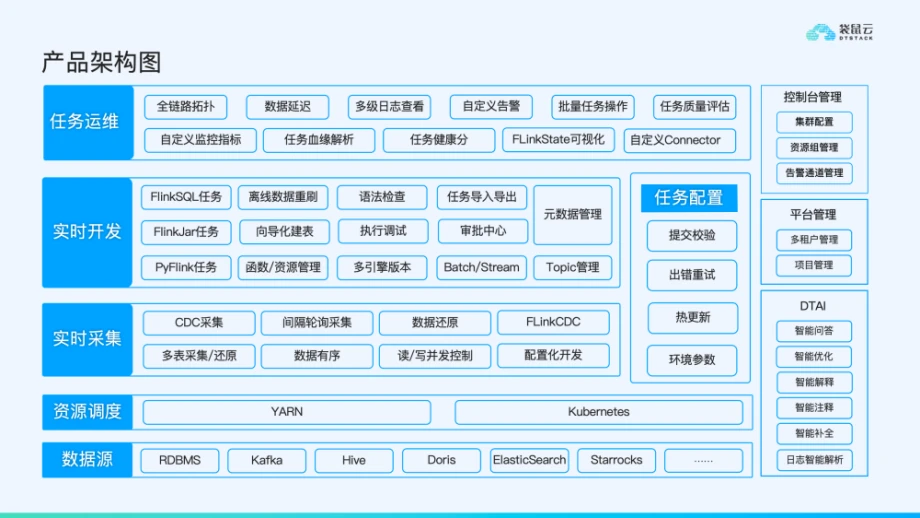
更进一步,数栈在存储层面同样实现了多模态对接——既支持HDFS等传统大数据存储,也支持MinIO、AWS S3等对象存储。调度与存储的双层解耦,使得企业可以根据自身的数据规模、团队能力和架构阶段,灵活选择最适合的资源底座组合,而非被单一技术栈锁定。
六、结语
YARN与Kubernetes的调度选型,本质上是大数据平台从“集成式集群”走向“组合式平台” 这一宏观演进在资源调度层面的投射。两者并非替代关系,而是在不同约束条件下各自最优的解。袋鼠云实时开发平台以双栈支持的方式,为这一过渡期提供了兼具兼容性与前瞻性的基础设施——让企业可以在不颠覆现有投资的前提下,逐步走向云原生。
