


高质量数据集建设方法:“规、采、预、标、验”全生命周期管理
面向AI任务,系统解析高质量数据集建设“规、采、预、标、验”五环节及全周期运营机制,覆盖数据需求规划、多源采集、预处理、专业标注、模型验证、质量安全与版本血缘管理,助力企业构建可持续迭代的数据资产。

高质量数据集建设不是对既有数据进行一次集中清洗和整理,而是一项围绕人工智能任务持续运行的数据工程。其建设过程既要解决数据从哪里来、如何加工、怎样保证质量等传统数据工程问题,也要进一步回答数据能否支撑模型理解业务、完成任务并持续优化。
高质量数据集建设包括数据需求、数据规划、数据采集、数据预处理、数据标注、模型验证六个阶段。
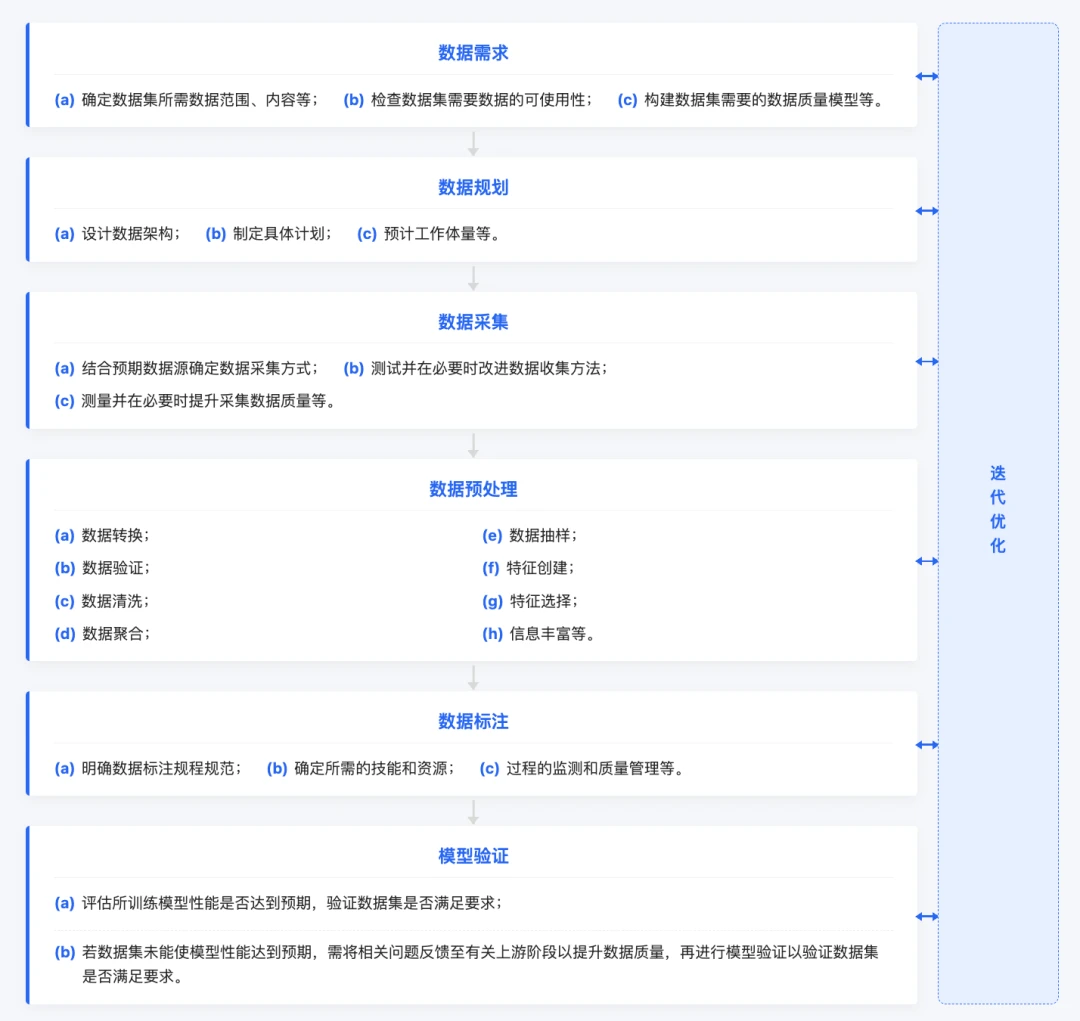
图:高质量数据集建设六阶段
结合企业实际建设过程,袋鼠云将上述六个阶段进一步归纳为“规、采、预、标、验”五个关键环节:
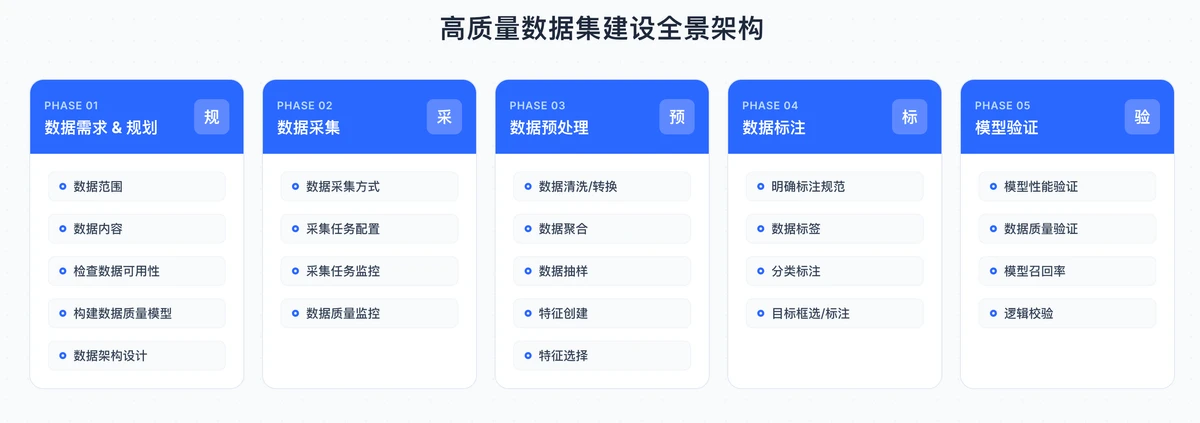
图:高质量数据集建设链路
- 规,包括数据需求与数据规划,明确为什么建设、建设什么、服务什么任务;
- 采,面向企业多源异构数据建立稳定的数据供给机制;
- 预,对结构化、时序、文档、图片、音视频等数据进行针对性加工;
- 标,根据任务需要,通过专业标注沉淀行业知识、业务规则和专家判断;
- 验,将数据集用于模型开发和实际任务测试,通过应用效果检验数据质量。
质量管理、安全合规、元数据与血缘、版本运营等能力贯穿整个生命周期,使高质量数据集能够随着业务、数据和模型持续演进。
(一)总体方法:以业务任务组织高质量数据集建设
高质量数据集与传统数据项目最大的差异,在于其建设目标与人工智能任务直接相关。
因此,高质量数据集建设需要首先建立四个对象之间的对应关系:
- 业务场景定义数据需求。 明确人工智能服务什么业务过程、解决什么问题,以及最终使用者是谁。
- 模型任务决定数据组织方式。 根据问答、检索、分类、预测、识别、生成、推理等不同任务确定数据形态。
- 质量目标决定加工深度。 不同任务对数据准确性、完整性、专业性、时效性和样本覆盖具有不同要求。
- 应用效果检验数据质量。 模型和业务应用成为判断数据集是否达到目标的重要依据。
企业由此可以建立一条完整的数据工程链路:
业务任务定义 → 数据需求与规划 → 数据资源采集 → 数据预处理 → 专业标注 → 模型验证 → 问题反馈 → 数据集迭代
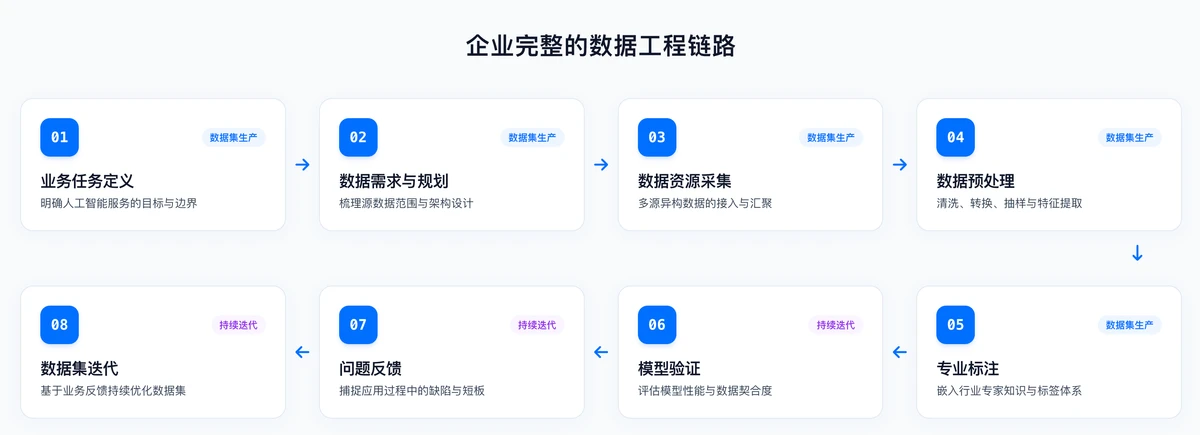
其中,前五个环节完成数据集生产,模型验证和应用反馈则持续推动数据集更新。
这种建设方式使数据工程与人工智能应用形成直接联系,避免数据建设与实际业务需求脱节。
(二)规:将业务需求转化为明确的数据集建设任务
“规”包括标准生命周期中的数据需求和数据规划两个阶段。
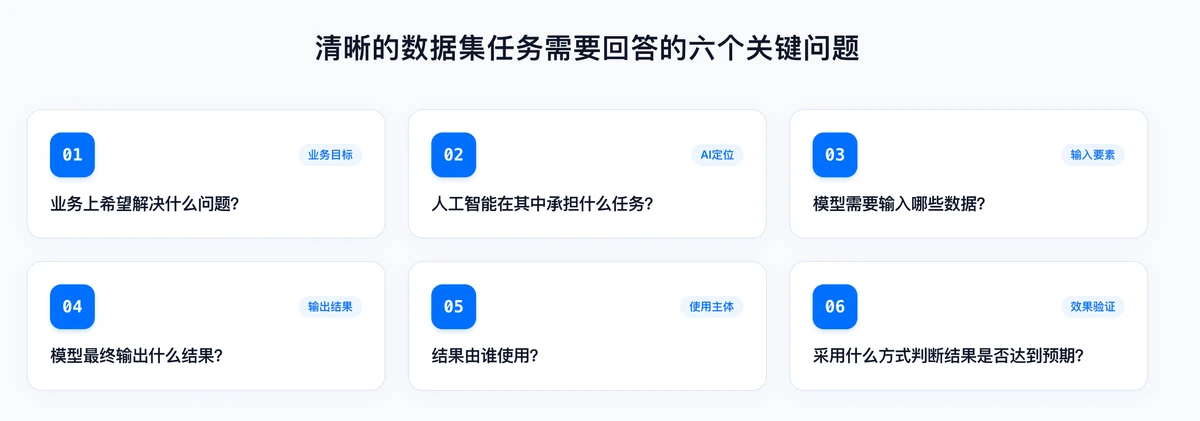
图:清晰的数据集任务需要回答的六个关键问题
高质量数据集建设的起点,是先把业务问题翻译成数据问题。企业需要明确AI究竟要完成什么任务,再反向确定需要哪些数据、数据之间是什么关系、什么样的质量才算合格。知识问答关注知识覆盖、版本和来源,设备诊断需要把设备、工况、时序参数、异常事件和维修结果串联起来,风险识别则要连接客户、交易、授信、担保和历史处置结果。由此,高质量也不再只有准确性、完整性这类通用标准,还要看样本是否覆盖真实场景、专业标签是否可靠、数据能否支撑模型完成具体任务。
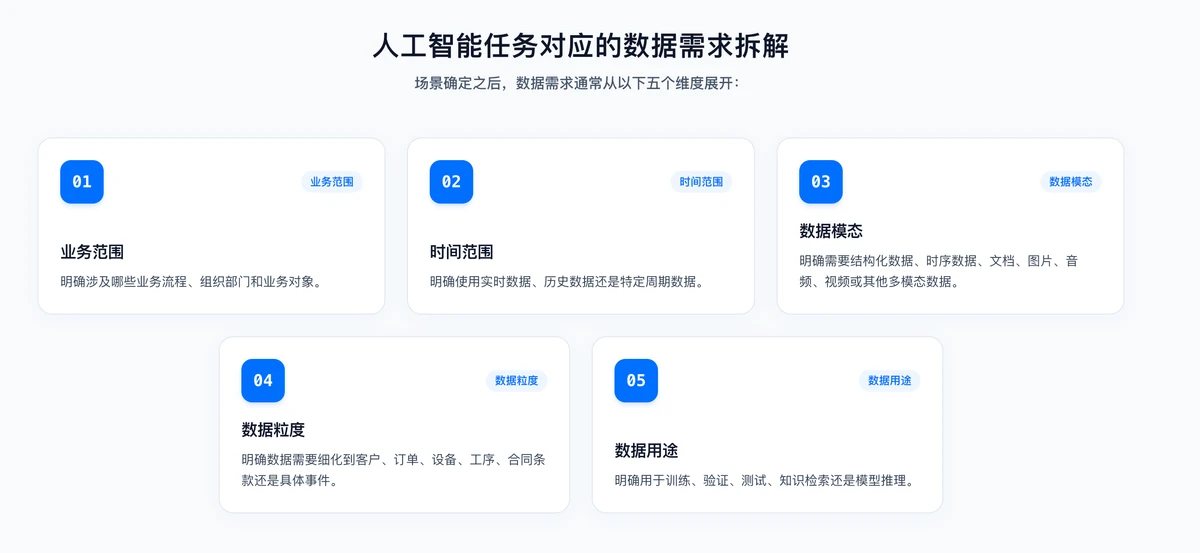
图:人工智能任务对应的数据需求拆解
对企业而言,更现实的做法是优先选择业务价值明确、数据基础较好、效果可以验证的场景形成首批样板,再同步固化数据范围、加工规则、质量标准、责任主体和验证方式,为后续复制扩展建立一套可执行的数据建设规范。
(三)采:形成稳定、完整的多源异构数据供给
产业场景的数据具有明显的多源、多模态特征。
企业高质量数据集的数据可能同时来自业务数据库、数据仓库、设备系统、文件系统、知识库以及外部数据资源。
数据采集阶段需要解决两个问题:一是把需要的数据稳定获取出来,二是尽可能保留其原始业务语境。
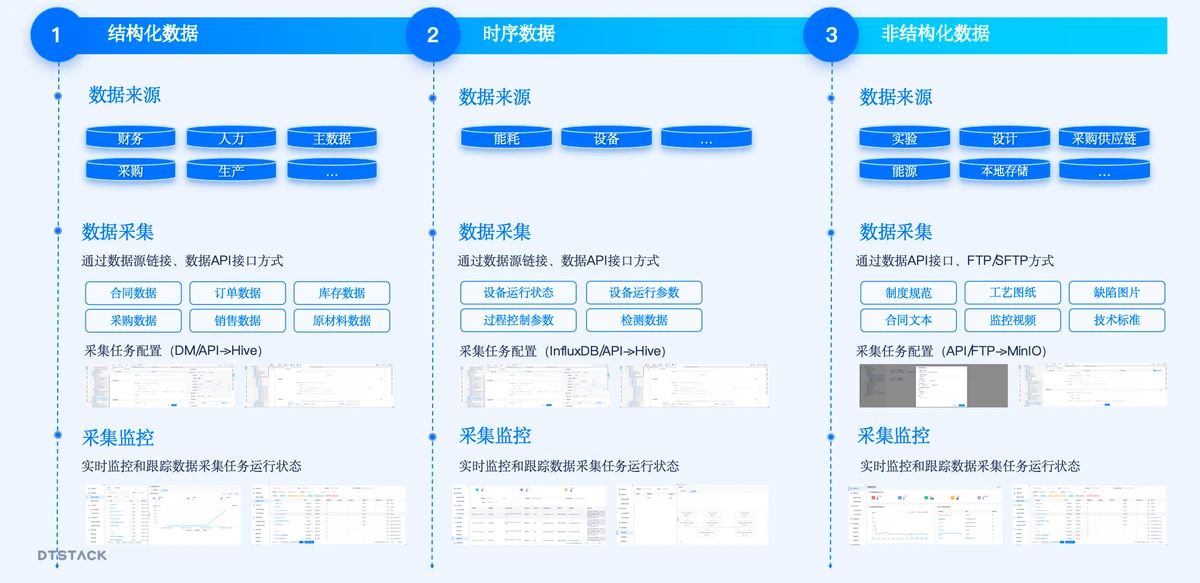
图:多模态数据汇聚
(四)预:将原始数据预加工为AI能够理解的数据内容
“预”解决的是原始数据如何真正进入AI应用。
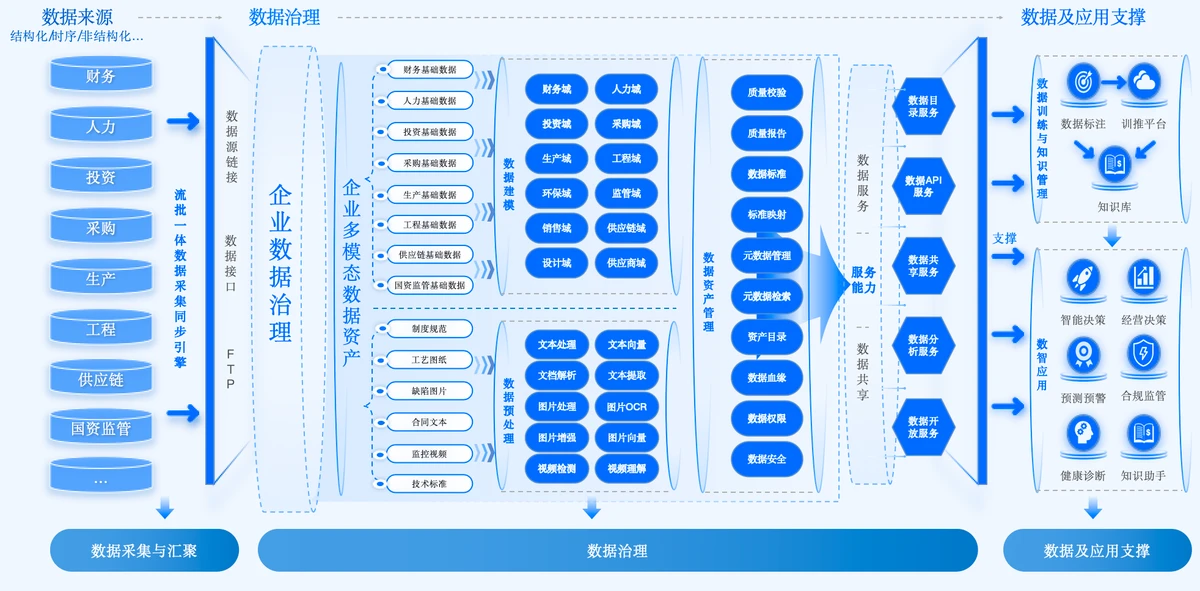
企业采集到的结构化数据、文档、图片、视频、音频和时序数据,往往存在格式不一、语义缺失、噪声干扰和上下文割裂等问题,需要按照不同数据形态进行针对性加工:结构化数据统一标准与业务口径,文档保留章节、表格和语义结构并提取专业知识,图片与视频完成质量处理、内容识别和关键片段提取,时序数据则通过时间对齐、状态关联和事件标记形成可识别的业务过程。更关键的是,这些数据最终还需要围绕客户、设备、产品、项目等统一业务对象建立关联,使传感器曲线、维修记录、故障图片和技术手册能够共同描述同一个业务事实。经过这一阶段,原本分散的数据逐步形成结构规范、语义清晰、关系完整、适合模型理解和使用的数据内容。
高质量数据集
围绕采集、清洗、标注、评估、治理与合规管理,把多模态原始数据构建为面向 AI 与业务应用的高质量数据集。
(五)标:将专业规则和专家经验沉淀为任务样本
数据标注是高质量数据集生命周期中的关键环节之一。
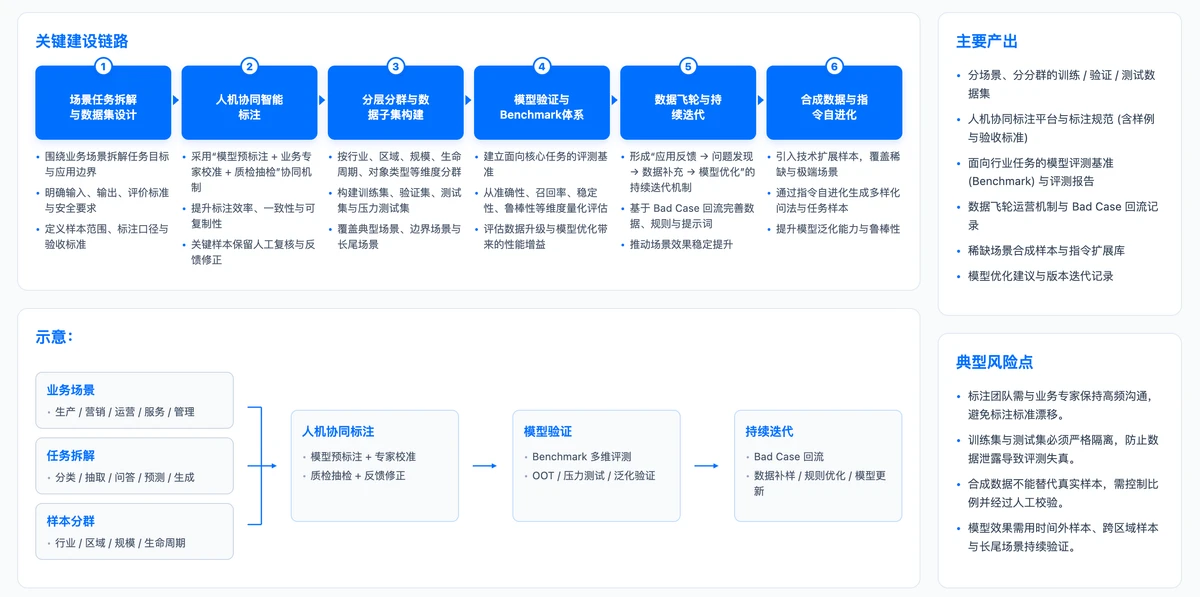
图:场景驱动的智能标注与模型验证链路
“标”解决的是如何把专业判断转化为模型可学习的任务样本。对于分类、预测、检测、识别和复杂业务判断等任务,需要围绕真实业务建立清晰的标签体系,明确标签含义、判断标准和争议处理规则,并通过模型预标注与专家复核形成高效的人机协同机制。机器负责高频、标准化的数据处理,业务专家重点判断低置信度、边界模糊和高价值样本,在提升标注效率的同时保证专业准确性。更重要的是,标注过程本身也是行业Know-how数据化的过程——过去依赖经验判断的异常、风险和处置规则,可以逐步沉淀为标签、规则和典型样本,成为企业可持续复用的专业数据资产。
(六)验:通过模型和业务应用检验数据集质量
高质量数据集最终需要通过实际使用证明价值。
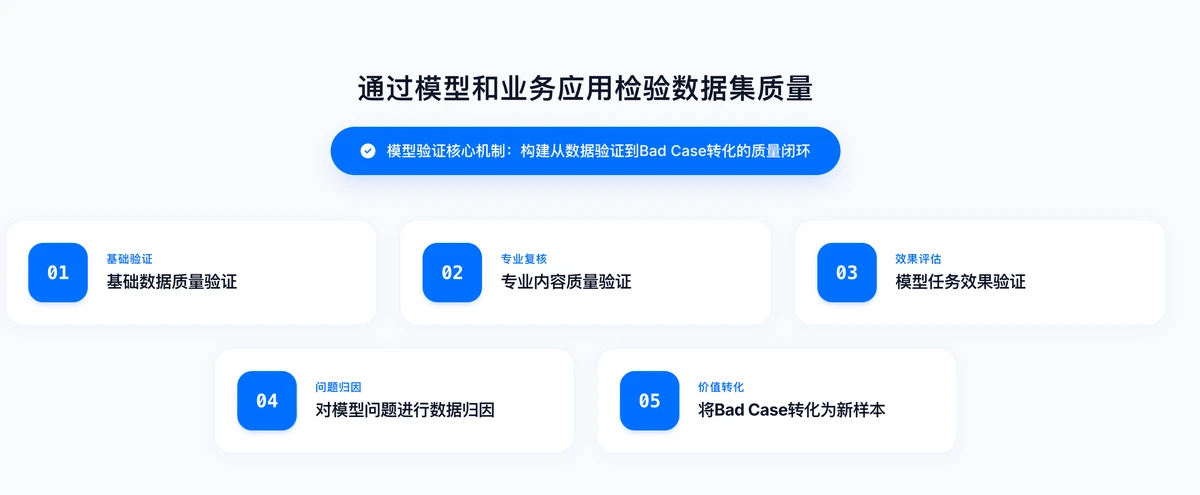
图:模型验证核心机制
“验”解决的是高质量数据集到底有没有真正支撑AI完成任务。除完整性、准确性、一致性等基础质量外,还需要通过业务专家检查专业知识、规则和标签是否准确,并让数据集真正进入模型和实际应用,用准确率、召回率、知识命中、专家评分等结果验证其有效性。更重要的是,模型表现还要反向用于发现数据问题:究竟是知识缺失、样本覆盖不足、标签偏差,还是数据本身存在错误。实际运行中持续产生的错误问答、漏识别、误判和人工纠正结果,也可以进一步沉淀为新的训练、验证和评测样本。由此,模型应用本身也成为数据生产的一部分,推动高质量数据集在真实业务反馈中持续迭代。
(七)全周期管理:建立持续的数据集质量与运营机制
高质量数据集建成后,还需要长期运营。
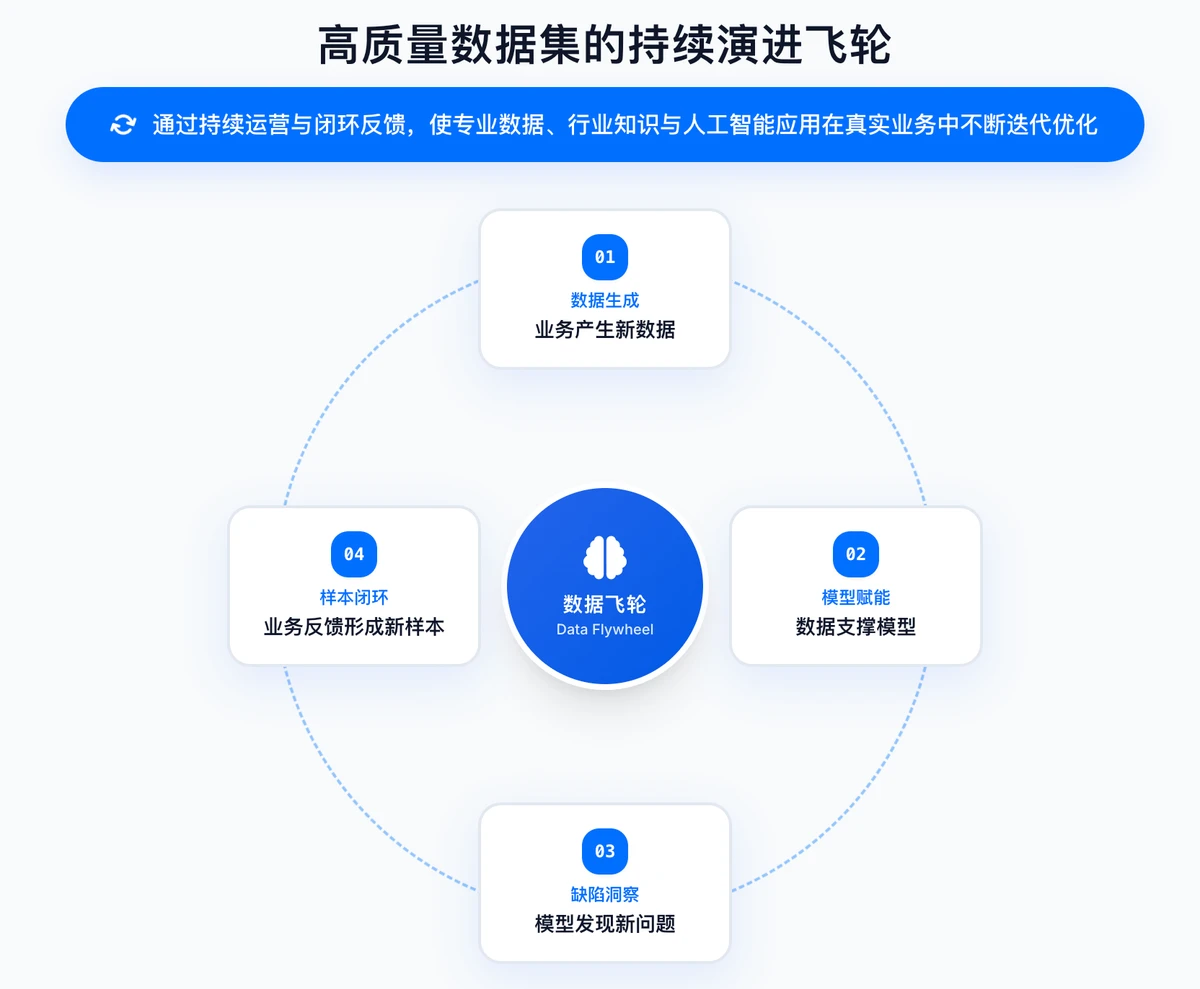
图:高质量数据集持续飞轮迭代
“全周期管理”解决的是高质量数据集如何持续保持可用。企业业务、制度、设备和模型都在变化,重点数据集也需要同步更新,因此需要建立覆盖版本、质量、血缘、安全和业务反馈的长期运营机制:通过版本管理记录数据变化,通过质量监控及时发现缺失、异常和分布漂移,通过元数据与血缘明确数据来源、加工过程和应用范围,并结合分类分级、权限和审计保障数据安全。更关键的是,要把模型运行中的Bad Case、业务规则调整和专家修正持续回流到数据集,使新数据、新知识和新样本能够不断进入下一轮建设。由此,高质量数据集逐步形成“数据更新—模型使用—问题反馈—持续优化”的运营闭环,成为能够随业务和AI能力共同演进的数据资产。
