


实时ChunjunCDC与达梦数据库深度集成实战
在信创产业加速推进的今天,国产数据库正从能用走向好用,本文系统梳理ChunjunCDC与达梦数据库集成的技术挑战与解决方案。

作者:番薯
在信创产业加速推进的今天,国产数据库正从“能用”走向“好用”,逐步成为企业数字化转型的技术底座。达梦数据库作为国产数据库的佼佼者,其在金融、政务、能源等领域的规模化应用,对数据实时采集和同步提出了更高要求。近期,我们在实时日志采集项目中新增了对达梦数据库的支持,实现了秒级数据同步和完整的数据变更追溯,进一步完善了国产化数据源生态。本文将系统梳理 ChunjunCDC 与达梦数据库集成背后的技术挑战与解决方案,为同类实践提供参考。
一、为什么需要 CDC 而不是传统轮询?
传统数据采集多采用间隔轮询的方式,通过定时查询源表来感知数据变化。这种方式不仅时效性差(分钟级延迟),还会对源库产生持续查询压力,更重要的是无法捕获完整的数据变更过程(如 UPDATE 和 DELETE 操作的历史轨迹)。随着数据审计、合规监管需求的增强,企业需要一套能够实时捕获每一次数据变更、并还原其完整事务上下文的同步机制。
ChunjunCDC 基于日志解析的 CDC 技术,直接读取达梦数据库的归档日志,通过 LogMiner 分析日志内容,从源头实时捕获插入、更新、删除操作,延迟可降至秒级,且完整保留变更前后的数据快照。这对于审计追溯和实时数据湖、实时数仓的构建至关重要。
二、技术挑战:从日志到变更事件有多难?
尽管原理清晰,但实际落地过程中,我们遇到了多个核心技术瓶颈,主要集中在数据变更捕获和配置管理两大层面。
1. 数据变更捕获的三大“拦路虎”
- UPDATE 语句解析异常:达梦日志中记录的 SQL 语句并非标准 DML,尤其在涉及 timestamp、date 等特殊数据类型时,会显示为
"c3" = TIMESTAMP'2025-09-04 16:01:17'这样的内部表达形式。直接解析容易出错,需要进行格式兼容转换。 - CDC 增量捕获功能失效:由于日志归档策略或权限问题,LogMiner 无法正常加载所需的归档日志文件,导致增量捕获中断。
- 归档日志获取失败:在分布式或主备环境下,日志文件分散在不同节点,若未正确配置归档路径或权限,读取日志时就会报错。
2. 配置与运行期问题
- 归档文件权限不足:达梦的归档日志文件默认权限可能限制非 DBA 用户读取,导致 LogMiner 加载失败。
- 日志存档配置错误:未开启归档模式,或归档路径设置不当,使 CDC 程序无法找到对应的日志文件。
- 增量阶段连接异常:在长连接或断点恢复时,由于 SCN(系统变更号)处理不当,造成数据重复或丢失。
数栈·多模态数据智能平台
袋鼠云面向 AI 时代打造的多模态数据智能平台,一站式覆盖数据存算、开发、治理、资产、服务与指标、分析、AI 应用,构建可见、可用、可管、可理解的私域数据底座。
三、基于 FlinkCDC 的 LogMiner 采集通道
我们的 ChunjunCDC 对接设计充分考虑了现有技术栈和长期维护成本。虽然数栈 Flink 的 logminer 插件可直接使用,但为了统一技术路线、减少后续并行维护的压力,最终决定借鉴 FlinkCDC 的 Oracle CDC 连接器思想进行开发,适配其增量快照接口。该方案研发周期较长,需要结合项目交付时间合理规划。
1. 核心流程:日志文件循环处理模型
整个采集过程围绕 SCN 号推进,形成一个闭环:
- 过滤日志文件:根据当前记录的 SCN 号,从
v$archived_log视图中查询出所有first_change# >= 当前SCN的归档日志文件,并按 SCN 降序排列。 - 加载日志文件:调用
dbms_logmnr.add_logfile()将要分析的日志文件注册到 LogMiner。 - 启动 LogMiner:执行
dbms_logmnr.start_logmnr(Options=>2128),开始日志读取会话。 - 读取并构建变更记录:从
V$LOGMNR_CONTENTS视图中抽取所需数据(scn、commit_scn、事务ID、sql_redo 等),并根据操作码(1-INSERT、2-DELETE、3-UPDATE、7-COMMIT 等)过滤出目标表的变更事件。 - 发送数据到下游:将构建好的事件序列化后发送到 Kafka 等结果表。
- 关闭 LogMiner:执行
dbms_logmnr.end_logmnr()释放资源。 - 更新 SCN:用读取到的最新 SCN 重复步骤1,实现持续捕获。
2. 关键技术细节的深度打磨
(1)日志归档的动态刷新
生产环境中,若某段时间没有 DML 操作,归档日志文件不会自动切换,导致 LogMiner 一直无法读取到新内容。我们的策略是:增加一个可配置的“强制刷新间隔”参数(默认为0,即不自动刷新)。当检测到该间隔内没有新的归档日志产生时,自动执行 ALTER SYSTEM ARCHIVE LOG CURRENT; 或 ALTER SYSTEM SWITCH LOGFILE; 来触发日志切换,保证采集的连续性。
(2)特殊数据类型的解析
针对达梦日志中 timestamp、date 等类型被表示为 TIMESTAMP'...' 字符串的问题,我们综合参考了 Chunjun 的 LogMinerDmlParser#parse 方法和 FlinkCDC 的类似处理逻辑,通过正则匹配和类型映射,将其转换为下游可识别的标准 JSON 字段格式,确保“c3”这类列名被正确映射为原始列名和值。
(3)长 SQL 的切分与合并
当一条 DML 语句过长时,达梦会在 V$LOGMNR_CONTENTS 视图中将其切分成多行,sql_redo 被截断,并在后续行继续。采集程序必须在内存中按照顺序拼接这些片段,还原完整的 SQL 语句,否则解析将失败或丢失数据。
(4)最棘手的 Checkpoint 与位点管理
实时任务的状态恢复是 CDC 的灵魂。我们在实践中发现,仅用 SCN 作为位点存在两个致命问题:
- SCN 重复:一条 UPDATE 影响多行时,这些行的操作共享同一个 SCN,仅靠 SCN 无法区分,导致恢复时数据丢失或重复。
- 长事务跨文件:如果事务 A 开启后,事务 B 先提交,而 A 后提交,若 Checkpoint 记录了事务 B 的 SCN,则恢复时会过滤掉 SCN 更小的事务 A 的未提交部分,造成数据丢失。
我们的解决方案借鉴了 FlinkCDC 的 MemoryLogMinerTransactionCache 思路:在内存中为每个事务维护一个事件列表,只有在收到 COMMIT 事件时才将整个事务的变更下发。对于位点,我们设计了一个三维向量 (scn,commit_scn,index):
- scn:当前读取到的所有未提交事务中的最小 SCN(低水位),用于恢复时重新加载所有可能需要的日志文件。
- commit_scn:当前已经成功下发的最新事务的 commit SCN,恢复时直接过滤掉 commit_scn 之前的已提交事务。
- index:当多个变更共享同一个 SCN 时,记录是第几条数据,避免重复。
这个位点信息会随 Checkpoint 持久化到 Flink 状态后端,确保故障恢复不丢不重。
四、产品化落地:从技术验证到业务赋能
上述技术攻关最终转化为了产品需求,目前我们的实时计算平台已支持以下能力:
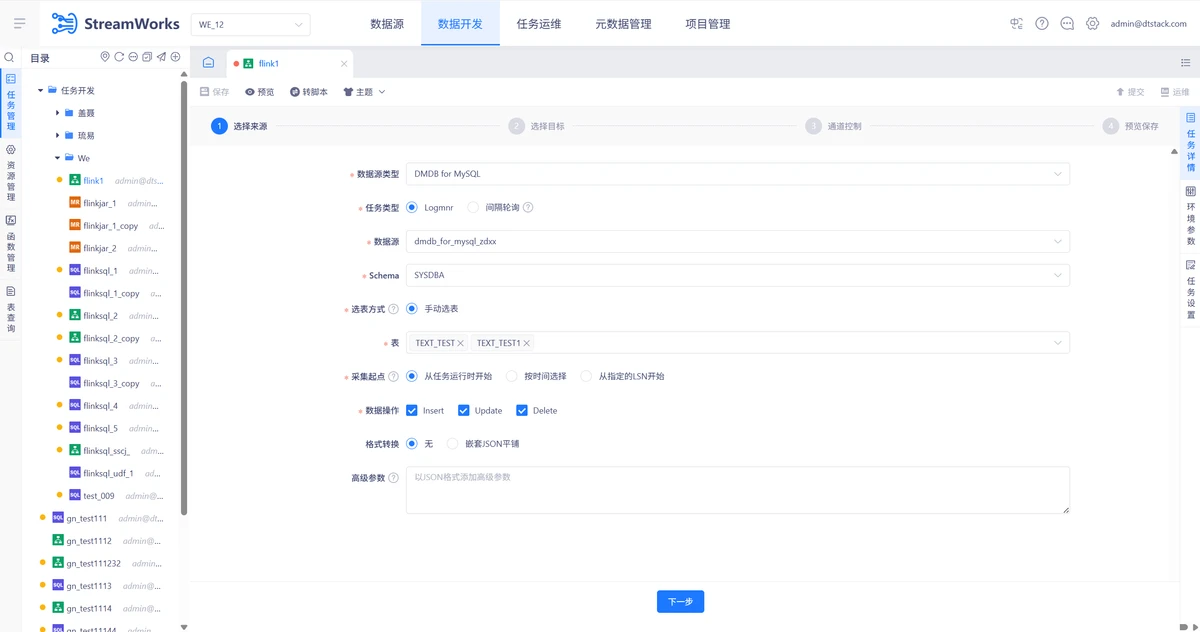
- 数据源兼容:支持 DM for MySQL 和 DM for Oracle 两种兼容模式,均通过 LogMiner 实时采集。
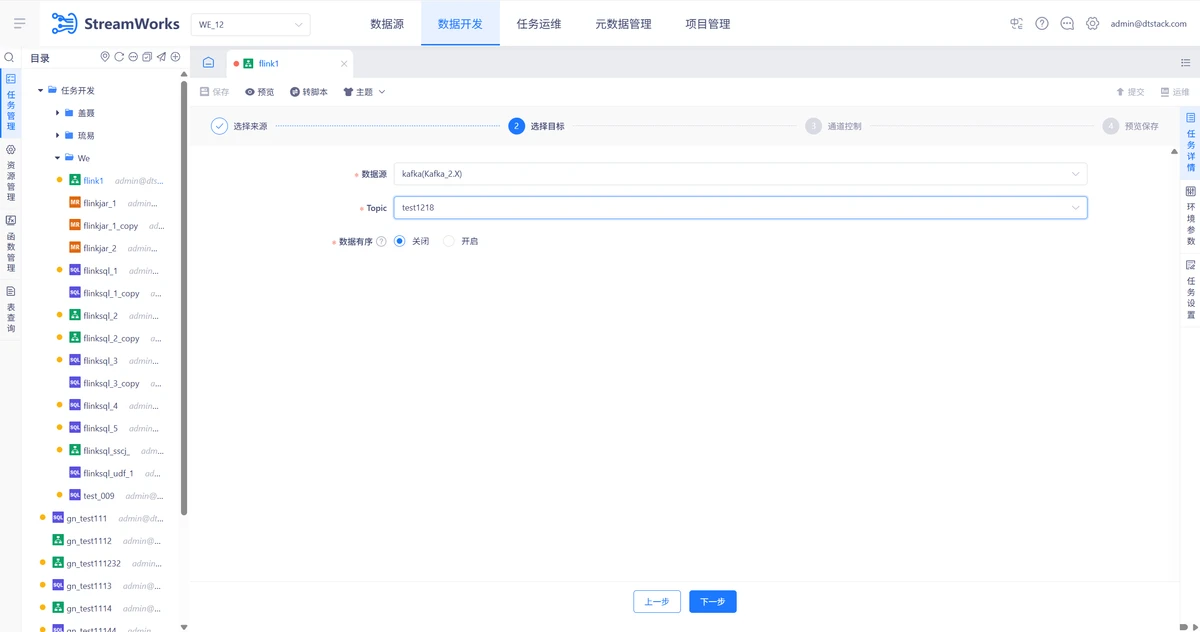
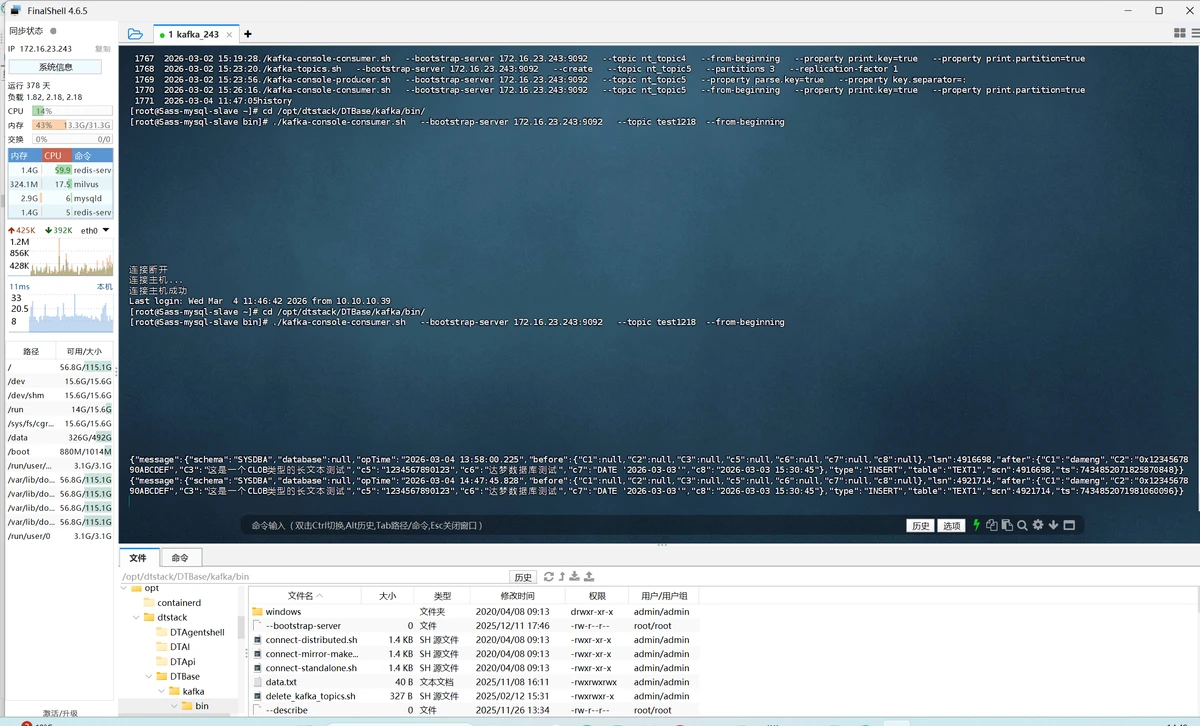
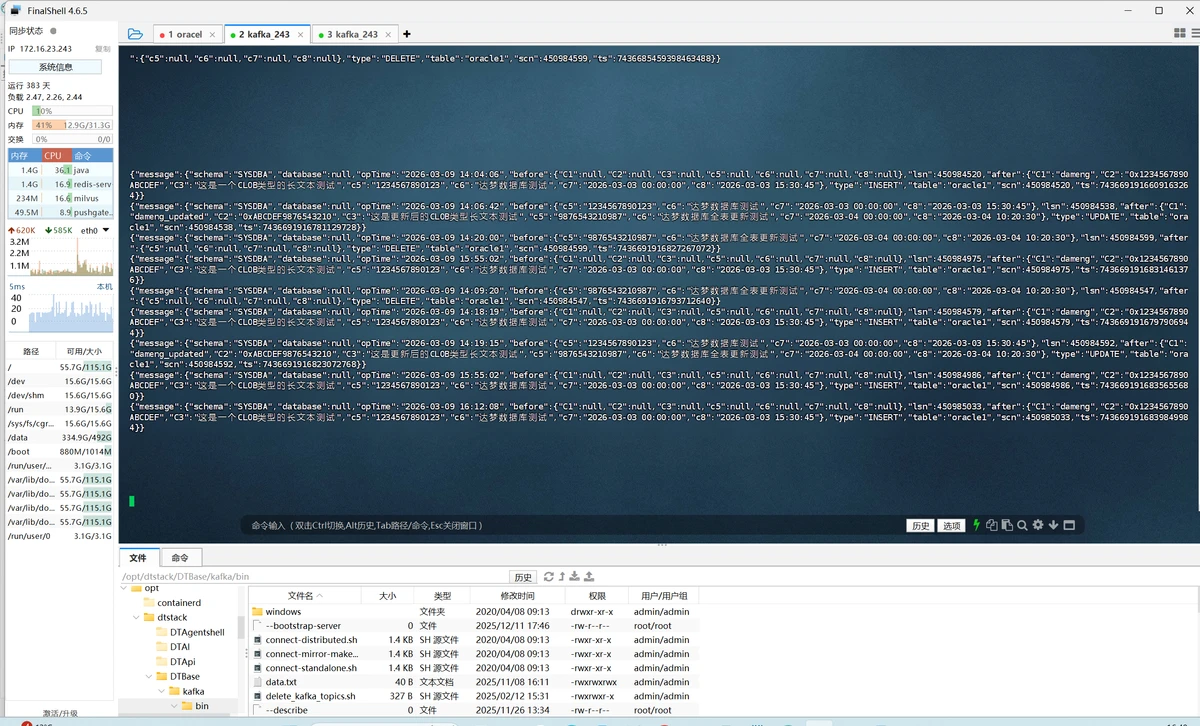
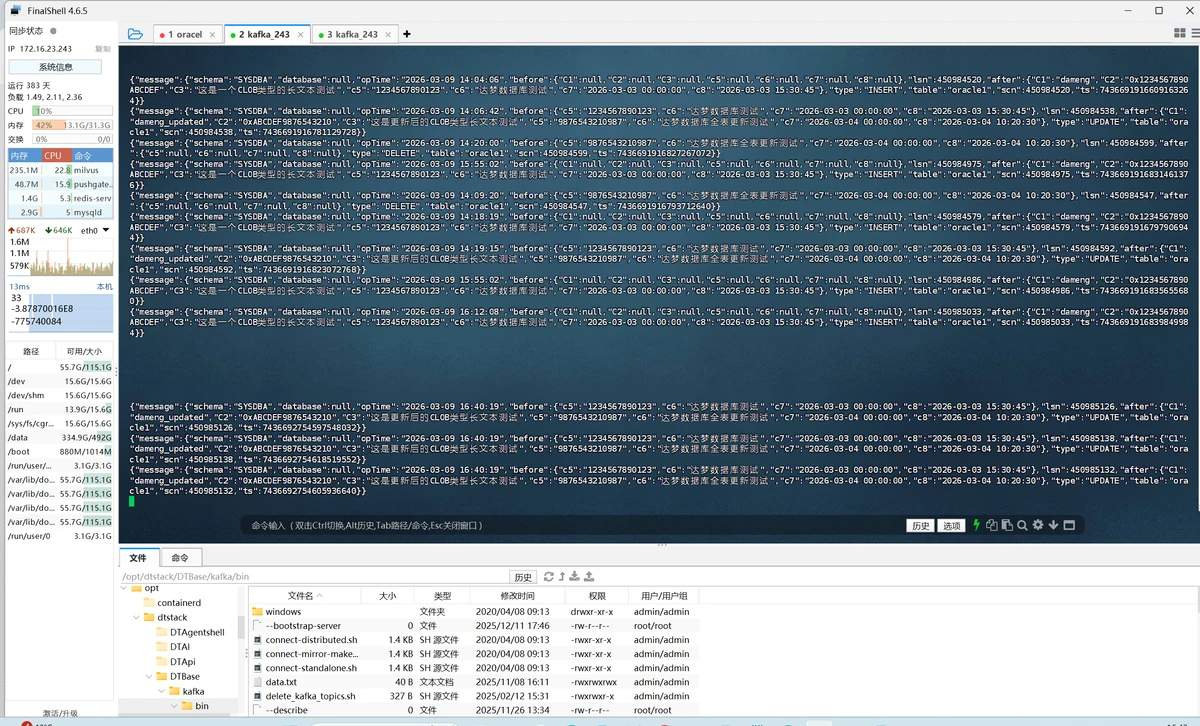
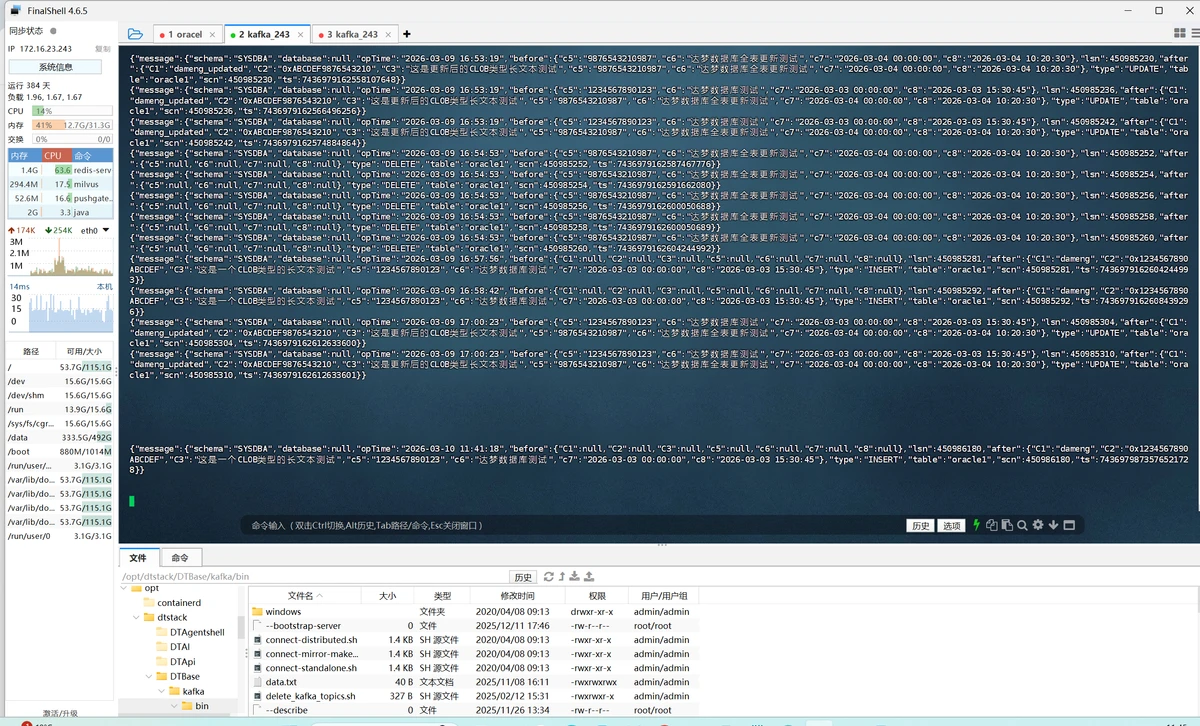
- 写入目标:当前支持写入 Kafka,输出 Chunjun-Json 格式,下游可直接用 FlinkSQL 消费并回写入达梦等其他数据源,形成完整的采集清洗链路。
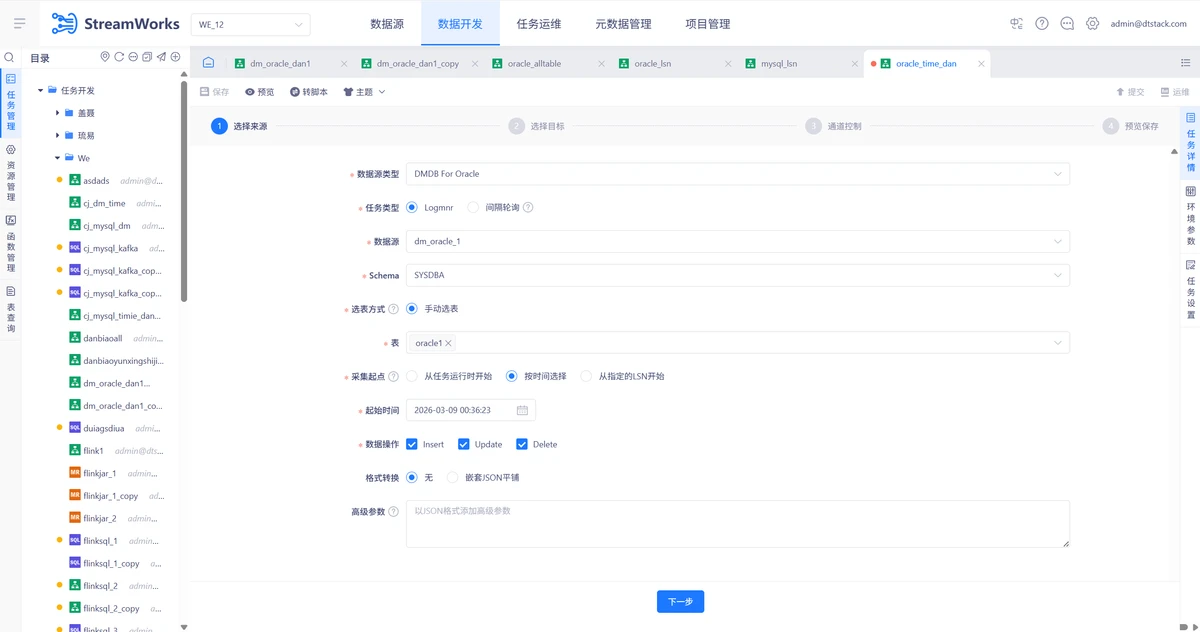
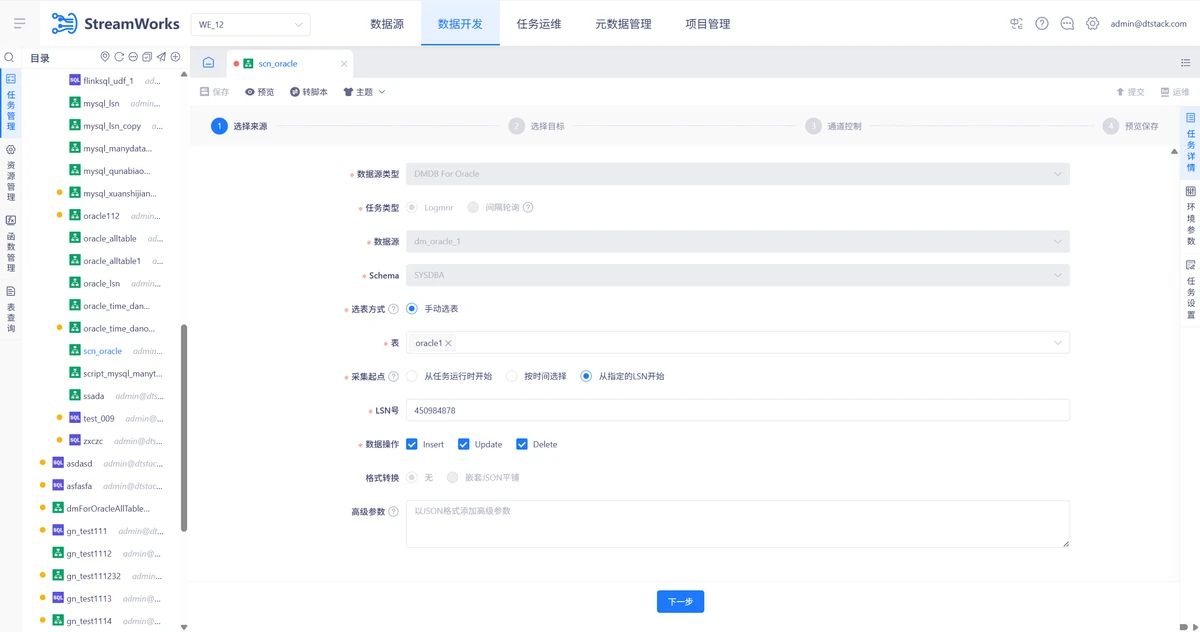
- 任务管理:新增 LogMiner 采集任务类型,支持手动选择多个源表,并可灵活配置 INSERT、UPDATE、DELETE 操作。
- 运维增强:集成 JobManager/TaskManager 日志、Metrics 监控、Checkpoint/Savepoint 管理、告警和脏数据展示,降低运维门槛。
- 部署模式验证:已完成 DM8 单机及主备(采集主节点)环境的全面测试,确保不同架构下的稳定性。
同时,权限体系也已明确输出:不同部署模式下需授予查询归档视图、执行 LogMiner 相关程序包的权限,并验证所有常用数据类型的兼容性,为用户交付提供详尽文档。
国产信创
面向国产化替代与信创改造场景,支撑数据平台平滑迁移、统一纳管、性能保障与安全可控。
五、实时计算真实运行场景
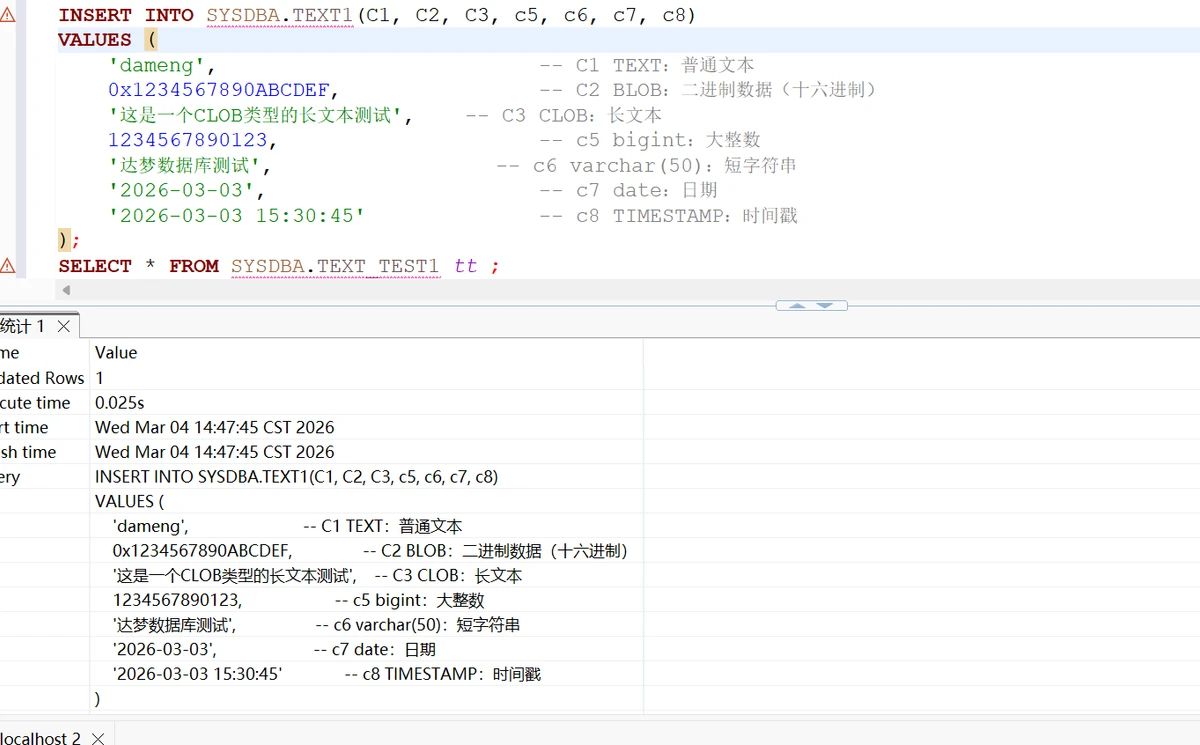
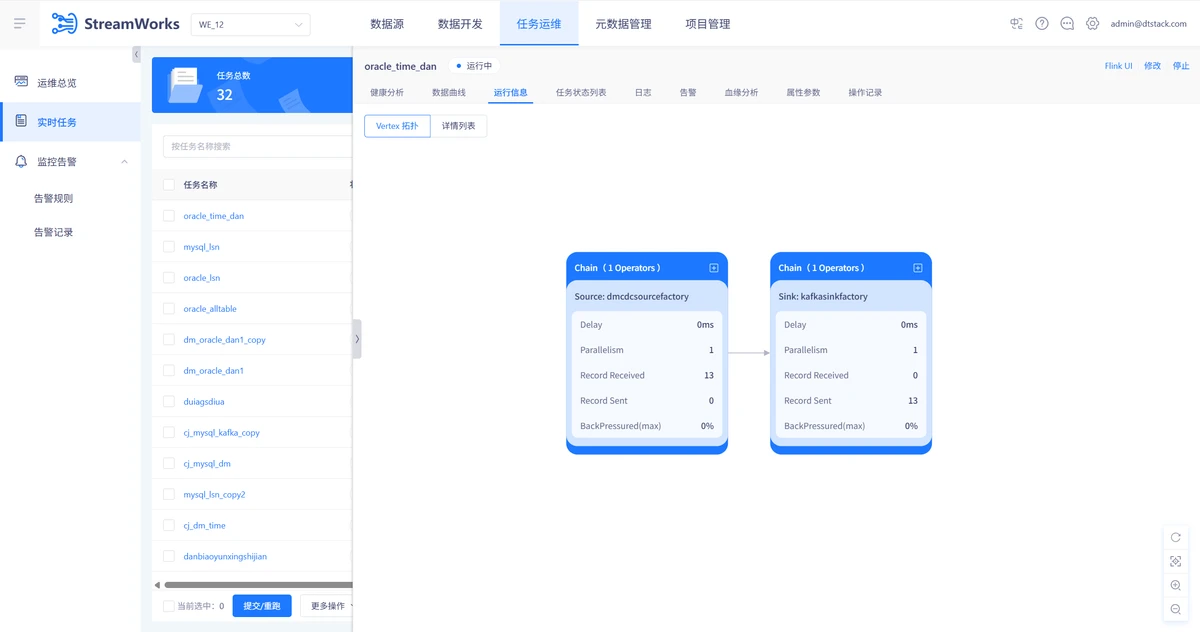
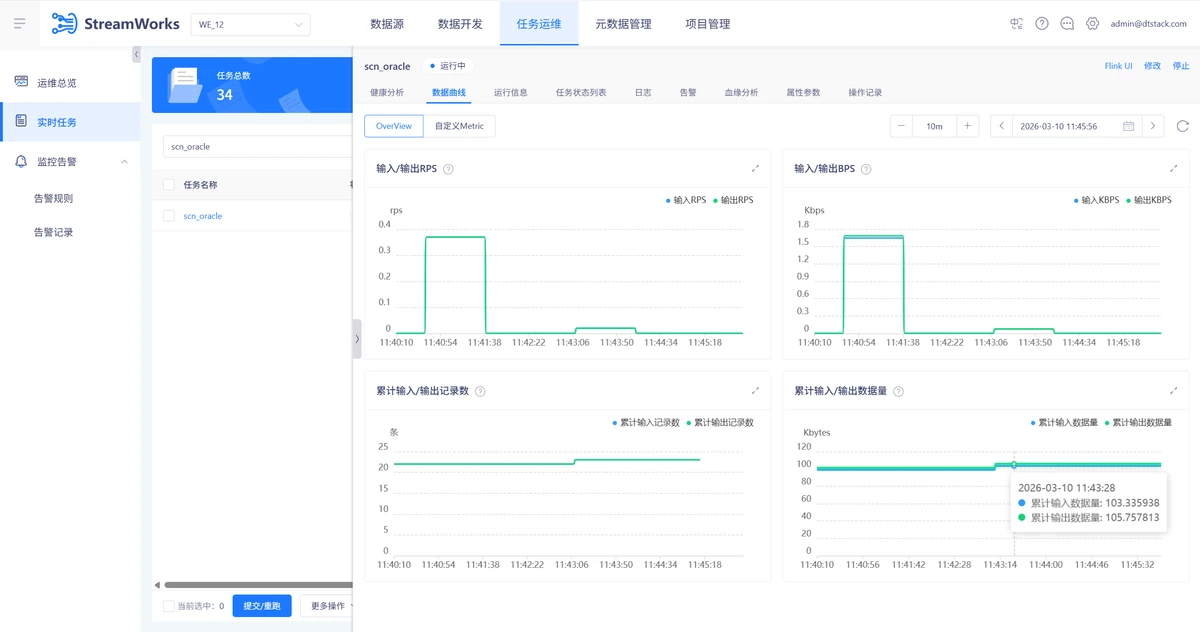
DM For MySQL 多表 Logmnr 模式采集写入 Kafka
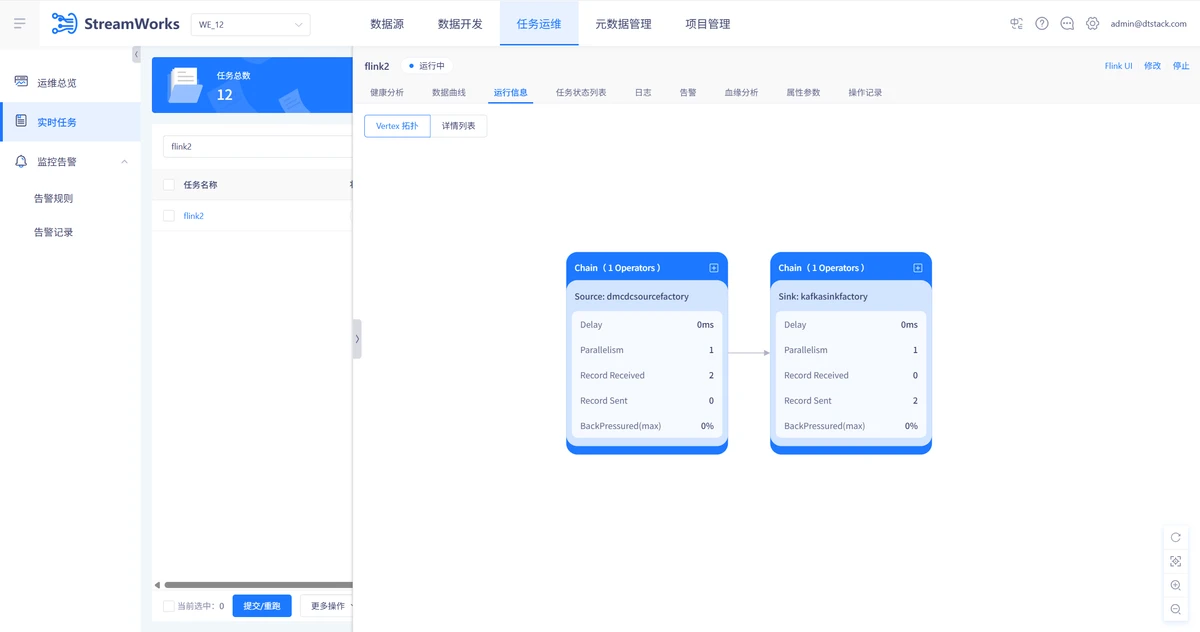
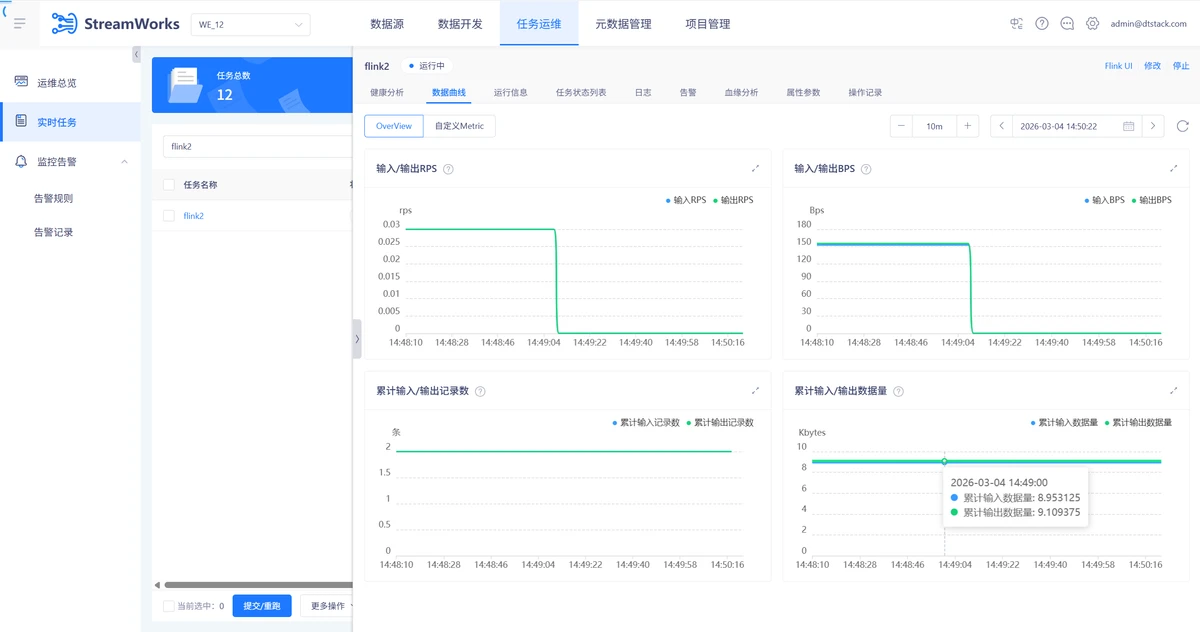
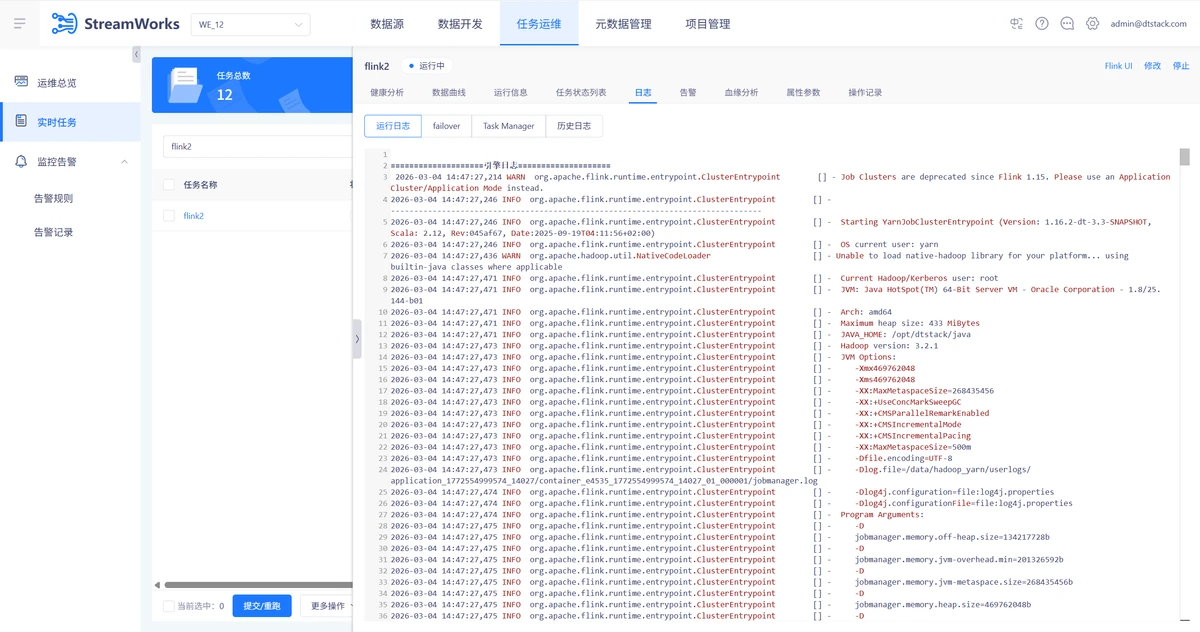
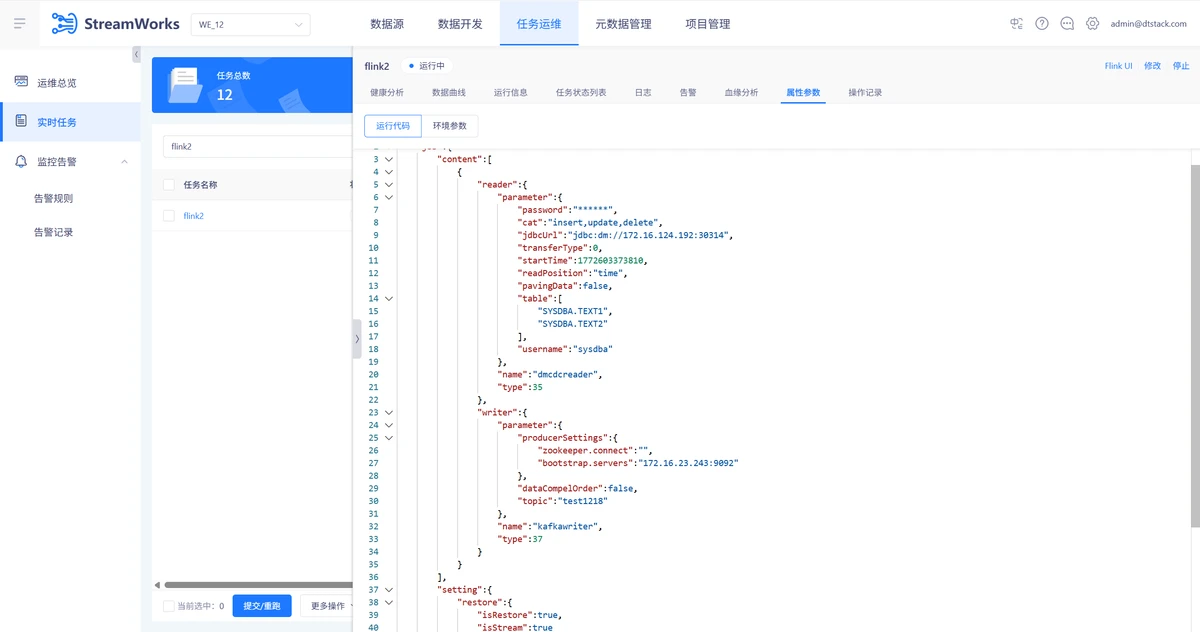
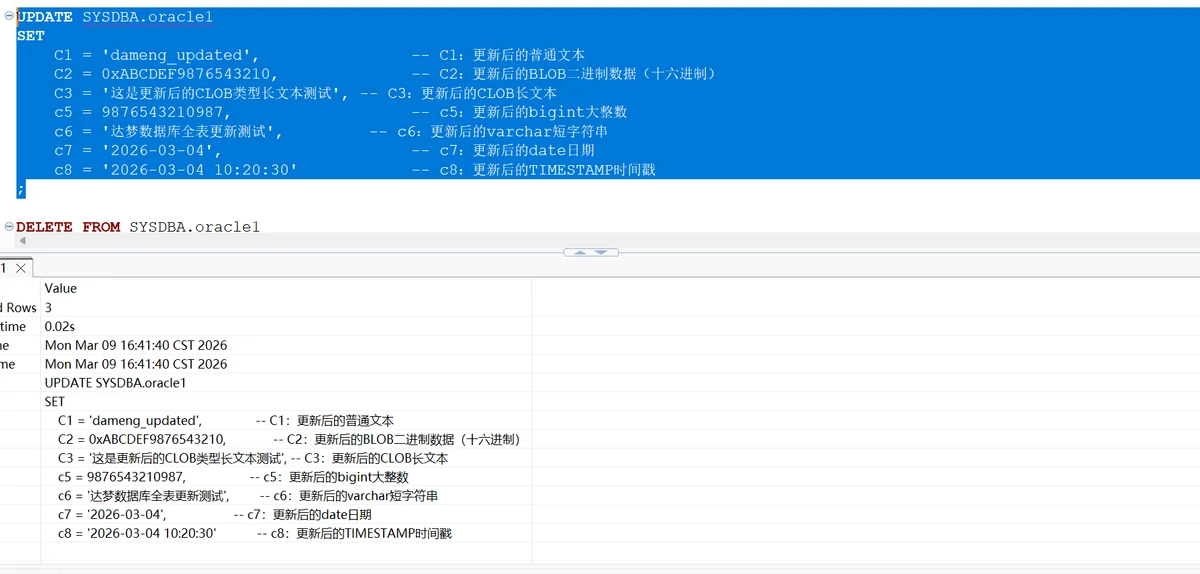
DM For Oracle Logmnr 采集起点选择 按时间选择 运行
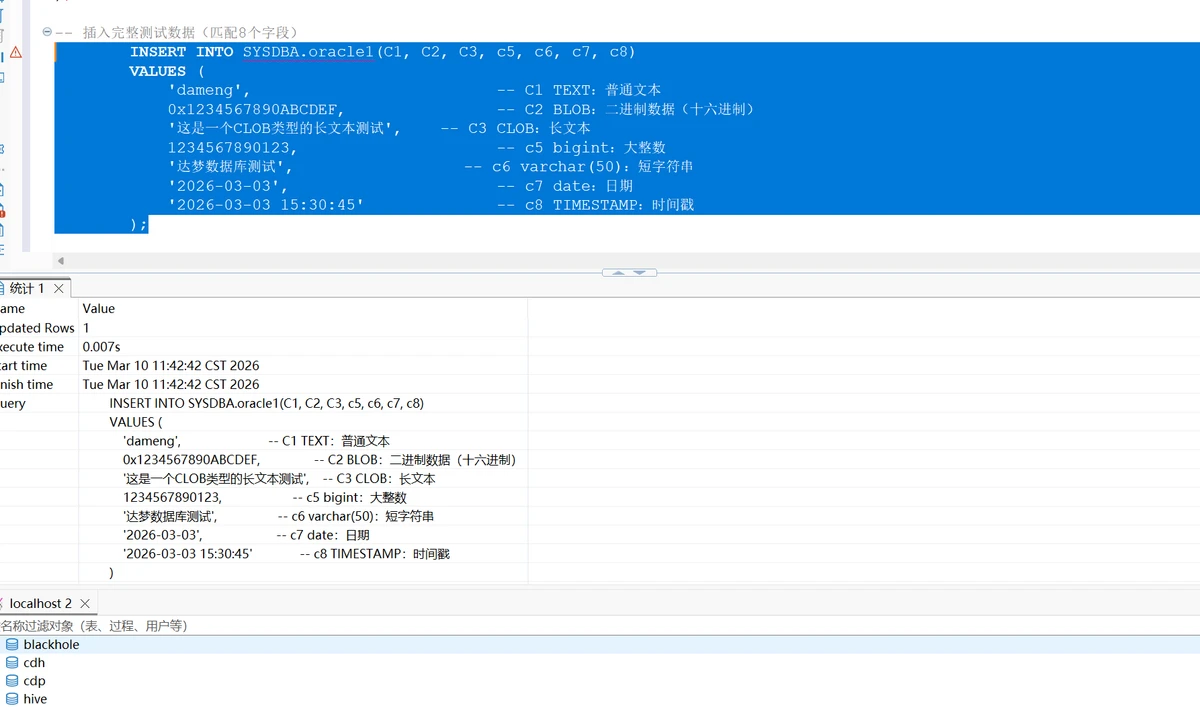
DM For Oracle Logmnr 采集起点选择从指定LSN开始采集
六、结语
达梦数据库与 ChunjunCDC 的深度集成,不仅打通了国产化数据生态中实时采集的最后一公里,更为后续信创体系下的流批一体数据架构铺平了道路。通过解决日志解析中的诸多技术细节,我们实现了从理论到生产级别的跨越,让秒级同步和完整变更追溯不再是纸上谈兵。未来,我们还将持续优化性能与稳定性,扩展更多国产数据库支持,助力企业构建安全、自主、高效的实时数据管道。
