


让 SQL 解析不再重复造轮子:SqlParserX 正式开源
一个纯 Druid 实现的多方言 SQL 解析引擎与工具包:表解析、表/字段血缘、函数解析、SQL 切分、行级权限改写,配套标准文档站与开箱即用的可视化解析平台。

一个纯 Druid 实现的多方言 SQL 解析引擎与工具包:表解析、表/字段血缘、函数解析、SQL 切分、行级权限改写,配套标准文档站与开箱即用的可视化解析平台。
项目地址:https://github.com/DTStack/SqlParserX 文档站:https://dtstack.github.io/SqlParserX/ 开源协议:Apache License 2.0
一、缘起:我们为什么要把 SQL 解析"重做一遍"
如果你做过数据平台、数据开发、数据资产或数据 API 这类系统,一定绕不开一个组件——SQL 解析器。
只要你想做这些事,就必然需要一个靠谱的 SQL 解析器:
- 从一段 SQL 里识别出它到底动了哪些真实表;
- 追踪数据加工链路,搞清楚表血缘、字段血缘;
- 识别 SQL 里用到了哪些函数;
- 把带动态变量的 SQL 脚本改写成可执行的预编译 SQL;
- 做行列级权限、SQL 脱敏、SQL 类型识别、脚本切分……
在数栈平台内部,SQL 解析能力过去主要由多个子产品分别承接:离线解析、API 解析、标签解析、实时解析等场景,会根据自身需求选用 Calcite、hive-exec、Druid、Flink Parser 等不同的解析框架。随着业务不断演进,这种相对分散的实现方式,在语法扩展、逻辑复用和长期维护上也逐渐显现出一些挑战:
- 不同数据源语法扩展能力有限:遇到新方言或新语法时,往往需要先做正则预处理,或在既有框架上单独扩展语法,扩展点相对集中;
- 解析框架较为多样:各场景各选其需,语法树结构与业务解析逻辑难以统一复用,维护成本较高;
- 血缘等业务解析门槛较高:需要先理解不同框架的节点定义与语法树结构,再实现转换与解析逻辑,整体学习与扩展成本不低。
为了更系统地应对这些问题,我们探索并落地了一套新的解析方案——对 SQL 解析做分层改造,把解析拆成"语法解析层 + 业务解析层"两层,并沉淀出一套可复用、可扩展的解析能力:
- 统一的 SQL 语法树采用 Druid:语法层基于 Druid 实现,后续由我们统一维护并持续扩展语法能力;
- 解析业务层由我们核心自研:基于这一套统一的语法树,自研并维护一套标准的核心解析框架结构,其他 SQL 类型直接继承扩展即可。
需要说明的是,这是一套面向未来的新方案:新接入的数据源会直接采用全新的分层实现,存量数据源则按计划逐步迁移替换,平滑过渡。
在这套新方案验证落地之后,我们做了一个决定:把这套核心的分层改造实现开源出去,做成一个纯净的、基于统一语法树的 SQL 解析器,让更多做数据平台的团队直接复用。
于是就有了 SqlParserX——一个无需依赖 Calcite、ANTLR 等其他解析组件,完全基于 Druid 实现各类 SQL 解析,并将不同数据源统一到一棵抽象语法树的开源项目。
二、SqlParserX 是什么
一句话概括:SqlParserX 是一套「Druid 语法解析层 + SqlParserX 业务解析层」的 SQL 解析中间件。
它采用两层解耦架构,各层职责清晰、可独立演进:
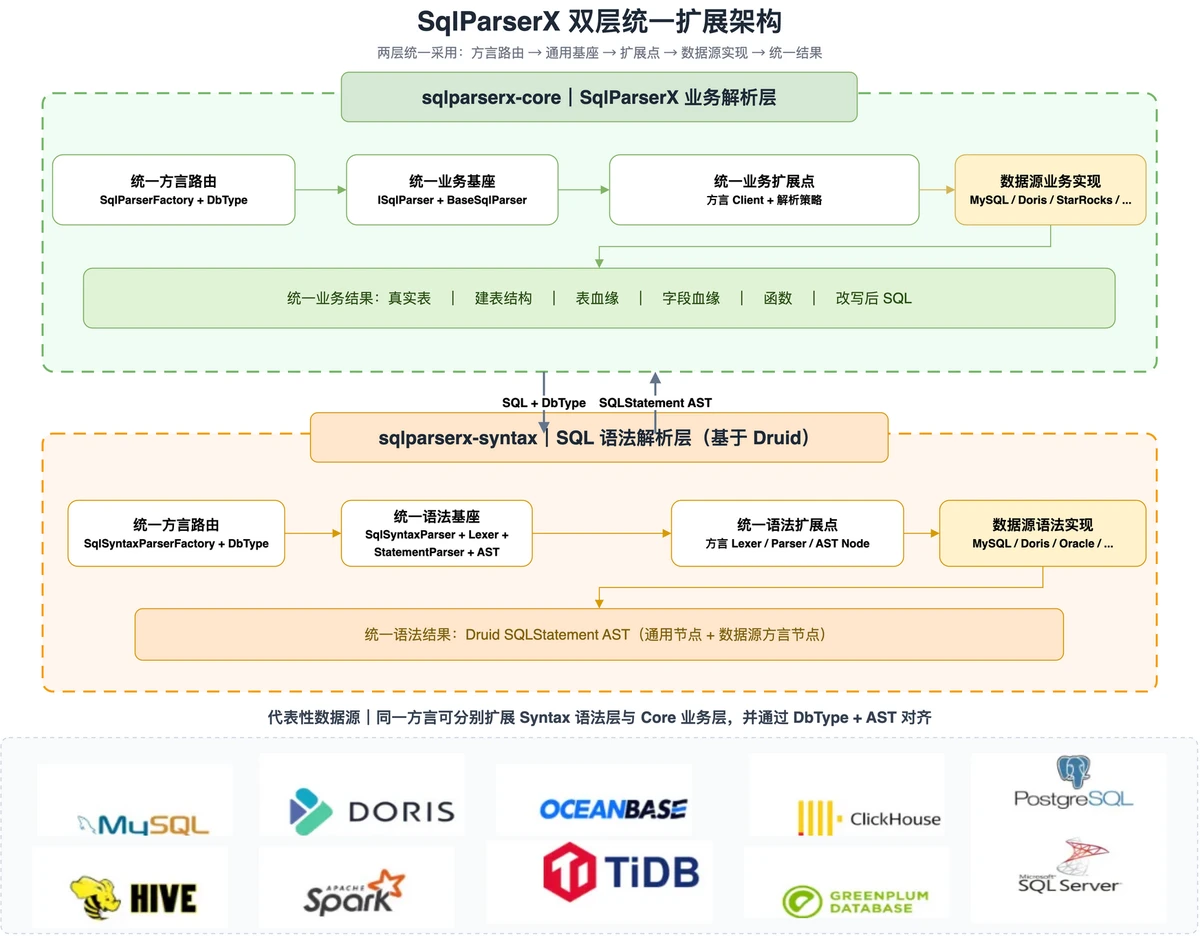
SqlParserX 两层架构
plain子产品封装层:  离线 / API / 资产 等子产品包(按需封装,复用核心解析能力)
                          │
能力出口层:  sqlparserx-web (REST :8888)  /  sqlparserx-ui (Vue + ECharts)
                          │  统一契约 ISqlParser
解析业务层:  sqlparserx-core(本项目自研)
                          │  SQL + DbType / SQLStatement AST
语法解析层: sqlparserx-syntax(Druid 1.2.28)值得一提:<font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">sqlparserx-core</font> 对外暴露的是一套统一的解析能力与契约。在其之上,不同的产品团队可以按各自的业务场景,进一步封装成离线、API、资产等子产品包,复用同一套核心解析能力,而不必再各自重复造解析轮子。
模块	层次	说明	技术栈
<font style="background-color:rgb(240, 240, 240) !important;">sqlparserx-syntax</font>	语法解析层	SQL → AST、多语句解析、SQL 切分及 Druid 方言语法扩展	Java 8 + Druid 1.2.28
<font style="background-color:rgb(240, 240, 240) !important;">sqlparserx-core</font>	解析业务层	表、血缘、建表、函数和 SQL 改写等业务解析能力	Java 8 + <font style="background-color:rgb(240, 240, 240) !important;">sqlparserx-syntax</font>
<font style="background-color:rgb(240, 240, 240) !important;">sqlparserx-web</font>	能力出口层	Spring Boot REST 服务,提供 HTTP API 并托管前端静态资源	Spring Boot 2.3.12 + Java 8
<font style="background-color:rgb(240, 240, 240) !important;">sqlparserx-ui</font> 能力出口层 前端工具集(血缘可视化、解析/校验/切分测试) Vue 2.7 + Element UI + ECharts 5业务层内部则是经典的「工厂 → 接口 → 基类 → 方言扩展」模式:
<font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">SqlParserFactory</font>(按 Druid <font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">DbType</font> 选择方言)→ <font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">ISqlParser</font>(统一契约)→ <font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">BaseSqlParser</font>(把 AST 分发给各 Client)→ 各方言实现(按需重写表/血缘解析)。
这套架构最大的价值在于:语法问题回到语法层按 Druid 的方式扩展,业务语义在业务层沉淀;通用能力沉到 Base,数据源差异按方言覆盖。 目前已经支持 15+ 种数据源方言(MySQL、Doris、StarRocks、Hive、ClickHouse、Oracle、达梦、OceanBase、PostgreSQL、Greenplum、Spark、SQL Server、TiDB、Trino 等)。
三、核心能力:把最常用的解析能力全部开源
SqlParserX 把数栈内部沉淀多年的基础解析能力做了开源:一方面将各场景通用的核心抽象方法进行统一规范,另一方面基于一套新的解析扩展思路进行扩展实现,从而支持不同数据源的 SQL 场景快速扩展,覆盖数据平台最常用的几类场景。
3.1 引入 pom 依赖
在业务工程的 <font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">pom.xml</font> 中引入业务解析层<font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">sqlparserx-core</font> 即可:
xml<dependency>
    <groupId>com.dtstack</groupId>
    <artifactId>sqlparserx-core</artifactId>
    <version>1.0-SNAPSHOT</version>
</dependency>
<font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">sqlparserx-core</font> 会传递依赖<font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">sqlparserx-syntax</font>(语法层)与官方 Druid,因此业务解析只需引入 <font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">core</font> 一个坐标;若只做 SQL → AST 的语法解析,也可以单独引入 <font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">sqlparserx-syntax</font>。
下面用三段核心代码,分别演示最常用的三类能力。
3.2 表血缘:看清数据在表之间的流转
从 <font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">INSERT</font>、<font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">CTAS</font> 等语句中追溯目标表与来源表,并输出表之间的依赖关系,同时支持 CTE 前向引用推断。
javaISqlParser parser = SqlParserFactory.getSqlParser(SqlParserDataSourceType.MYSQL);

TableLineageResult result = parser.parseTableLineages(
        "INSERT INTO db1.table1 " +
        "SELECT a.id, b.name FROM db2.table2 a JOIN db3.table3 b ON a.id = b.id");
result.getTableLineages().forEach(System.out::println);
输出:
plainTarget Tables:
    db1.table1
Source Tables:
    db2.table2
    db3.table3
3.3 字段血缘:把每个字段追溯到它的来源
字段血缘会把每个目标字段追溯回它的来源字段,覆盖表达式、聚合、<font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">CASE</font>、窗口函数、<font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">*</font> 展开和 CTE 等复杂场景。
javaColumnLineageResult result = parser.parseColumnLineages(
        "CREATE TABLE db1.summary AS " +
        "SELECT u.id AS user_id, SUM(o.amount) AS total_amount " +
        "FROM db1.users u JOIN db1.orders o ON u.id = o.user_id " +
        "GROUP BY u.id",
        tableColumnsMap /* 可选:传入真实表字段信息,用于 SELECT * 展开 */);

result.printColumnLineage();
输出:
plaindb1.users.id          -> db1.summary.user_id
db1.users.id, db1.orders.amount -> db1.summary.total_amount
3.4 SQL 改写:动态变量解析与预编译
这是很多"SQL 转 API / 数据 API"场景的刚需能力。用户在平台上手写一条带 <font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">${变量}</font> 的 SQL,平台据此生成标准 API,调用方按标准入参传值即可拿到结果。
SqlParserX 提供了两个核心入口,覆盖「配置期」和「运行期」:
- 参数提取(
<font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">parseParameterSql</font>):解析脚本中的<font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">${变量}</font>,得到变量名、位置、绑定字段、操作符、是否必填等信息,用于生成 API 入参配置; - 预编译改写(
<font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">buildSqlByPrepareCompile</font>):根据 SQL 中动态变量的位置,自动把**<font style="color:rgb(0, 174, 253) !important;background-color:rgb(240, 240, 240) !important;">${变量}</font>**替换为 JDBC**<font style="color:rgb(0, 174, 253) !important;background-color:rgb(240, 240, 240) !important;">?</font>**占位符,并输出按顺序排列的参数值列表,直接交给<font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">PreparedStatement</font>执行,既避免了字符串拼接,也天然防住了 SQL 注入。
javaISqlParser parser = SqlParserFactory.getSqlParser(SqlParserDataSourceType.MYSQL);

String sql = "SELECT * FROM db1.table1 WHERE dt = '${bizdate}' AND region = '${region}'";

// 1、参数提取:解析 SQL 中的动态变量(名称、是否必填、默认值、绑定的表字段等)
ParseParameterResult paramResult = parser.parseParameterSql(sql, false, null);
paramResult.getInputParams().forEach(p ->
        System.out.println(p.getName() + " / " + p.getDataType() + " / " + p.getSqlPart()));

// 2、预编译:传入参数值,得到 ? 占位符 SQL 与按序参数列表
Map<String, Object> inParams = new HashMap<>();
inParams.put("bizdate", "20240101");
inParams.put("region", "hangzhou");

PrepareCompileResult compileResult = parser.buildSqlByPrepareCompile(sql, inParams, columns);
compileResult.getBeautifulSql();   // SELECT * FROM db1.table1 WHERE dt = ? AND region = ?
compileResult.getInputFields();    // [20240101, hangzhou]
除此之外,SqlParserX 还提供了一套完整的通用解析能力:
能力	说明
SQL 类型解析	识别查询、写入、建表、管理语句等类型,支撑路由与校验场景
表解析	识别主表、真实表、CTE、子查询及多种 DML/DDL 场景
建表解析	提取表、字段、注释、分区、分桶、Key 和 properties 等结构信息
函数解析	提取 SQL 中使用的函数名称(普通/聚合/窗口函数)
SQL 切分	支持多语句脚本切分及 Druid 原生切分策略
行级权限改写	向查询、写入和更新 SQL 注入行级权限条件
所有能力都通过统一契约 <font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">ISqlParser</font> 对外暴露,一套 API 走遍所有数据源。
四、标准文档站:让接入有章可循
开源项目最怕"只有代码、没有说明"。SqlParserX 同步建设了一个标准的文档站,把核心 SDK 的使用规范、能力支持边界和扩展指南都讲清楚:
🔗 文档站:https://dtstack.github.io/SqlParserX/
文档站基于 Docusaurus 搭建,具备以下特点:
- 核心 SDK 使用规范:从环境准备、依赖引入,到表解析、表/字段血缘、函数解析、参数提取与预编译,每一类能力都有完整的「引入方式 + 可运行示例」;
- 能力支持矩阵:按「语法层能否生成正确 AST」和「业务层能否输出稳定结果」双重视角,维护了各数据源的语法/业务解析支持情况;
- 架构与扩展指南:包含双层架构设计、模块依赖边界,以及《解析能力标准迭代维护扩展指南》,告诉你新增数据源/新能力应该放在语法层还是业务层;
- 中英双语 + 版本管理:站点内置简体中文 / English 切换与版本下拉,方便国内外开发者阅读。
说明:SqlParserX 的能力支持需要同时检查"语法层"和"业务层",因此文档也按这两层分别维护,保证能力边界清晰、可追溯。
五、快速验证:开箱即用的平台服务
除了把能力集成进自己的系统,SqlParserX 还提供了一套开箱即用的平台站点服务(<font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">sqlparserx-web</font> + <font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">sqlparserx-ui</font>),用于快速启动一个 Web 服务来验证核心解析能力,无需写代码即可在页面上直接体验。
启动后,访问 Web 服务即可在浏览器里直接体验各类解析能力:
- 血缘可视化:输入一段 SQL,一键解析表血缘、字段血缘,并以图形化方式直观展示来源与目标的流转关系(基于 ECharts);
- 表解析 / 建表解析:可视化展示主表、真实表,以及建表语句中的字段、键、分区、分桶结构;
- 语法校验 / SQL 切分:在线验证 SQL 语法、切分多语句脚本;
- 参数解析与预编译工作台:在线体验
<font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">${变量}</font>提取与<font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">?</font>占位符改写。
模块	作用
<font style="background-color:rgb(240, 240, 240) !important;">sqlparserx-web</font>	Spring Boot REST 服务(默认端口 <font style="background-color:rgb(240, 240, 240) !important;">:8888</font> ),对外提供 HTTP API,并托管前端静态资源
<font style="background-color:rgb(240, 240, 240) !important;">sqlparserx-ui</font> Vue 2.7 + Element UI + ECharts 前端工具集,提供血缘可视化、解析/校验/切分测试等页面这相当于一个核心功能的场景示范:你可以把它当作一个独立的解析服务跑起来,用可视化页面快速验证表解析、血缘、参数解析等核心能力是否满足你的业务场景;验证通过后,再把 SqlParserX 当作 Java SDK 引入到自己的系统里即可。
六、快速上手
1)从源码构建
bashgit clone https://github.com/DTStack/SqlParserX.git
cd SqlParserX
mvn clean package -U -DskipTests
2)一键跑起来,打开可视化页面
参考项目 <font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">bin/</font> 目录下的启停脚本启动 <font style="color:rgb(51, 51, 51) !important;background-color:rgb(240, 240, 240) !important;">sqlparserx-web</font>,然后访问服务地址,即可在页面上体验表解析、血缘可视化、参数解析等能力。
七、写在最后
SqlParserX 的诞生,不是一次性的重构,而是一次次把问题放回正确层次的取舍:
语法问题扩展 Druid,业务语义扩展 SqlParserX;通用能力沉淀 Base,数据源差异按方言覆盖。
我们希望通过这个项目,让更多做数据平台、数据开发、数据资产、数据 API 的团队,不用再从零踩一遍 SQL 解析的坑,而是可以直接站在一个经过生产验证的分层解析引擎之上。
项目已开源,欢迎 Star、Issue 和 PR:
- 🐙**** GitHub:https://github.com/DTStack/SqlParserX
- 📖**** 文档站:https://dtstack.github.io/SqlParserX/
- 📄**** 开源协议:Apache License 2.0
如果你正在做多数据源的 SQL 解析、血缘、表解析相关工作,欢迎一起交流与共建,我们下期见。
作者:changlu | 项目:DTStack / SqlParserX
