


高质量数据集建设与Agent应用实践:从数据建设到业务验证

10月15日晚,爱分析&袋鼠云举行"以高质量数据为基础,构建多场景Agent应用"为主题的网络研讨会,袋鼠云解决方案总经理·红发带来《高质量数据集建设与Agent应用实践》主题分享。
从数据汇聚到AI赋能
高质量数据集的演进,与企业数据建设的发展脉络一致。2015年至2020年,企业推进大数据改造和数据中台建设,核心是把分散在各业务系统和数据库中的多元异构数据统一汇聚,解决数据从无到有的问题。2020年至2025年,随着数字化转型推进,数据中台逐步转向为业务和管理提供价值。2025年之后,AI与大模型能力快速发展,过往建设的数据需要为AI创造新价值,建设对象也不再局限于结构化数据,企业所有多模态数据都需要建设高质量数据集。
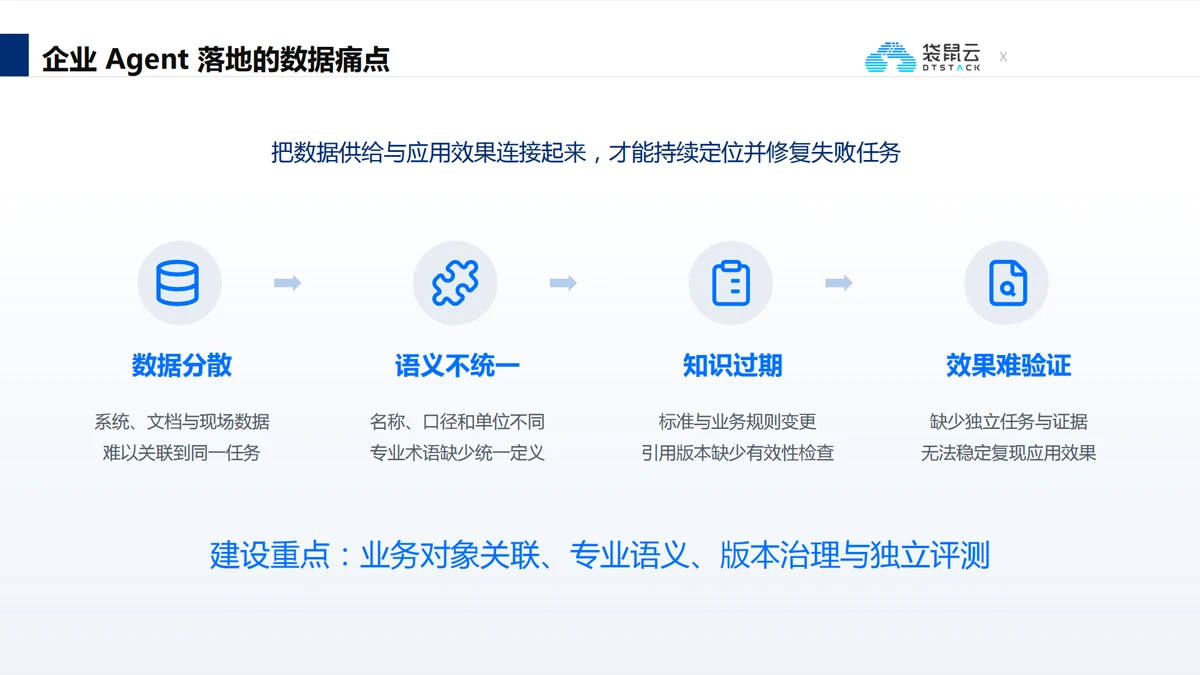
AI在企业落地面临四方面的数据问题:
**数据分散:**信息化系统、人工数据以及音频、视频、图片、文本等非结构化数据散落各处。
**语义不统一:**不同系统对同一字段的定义可能不同,例如性别在有的系统以0、1表示,在有的系统以A、B表示,不同模态之间的语义也可能不一致。
**知识过期:**知识容易过期、规则不统一、版本难以管理,既不能以过去的规则约束当下的执行,也不能以现行标准校验历史数据。
**效果难验证:**校验不能只从数据或技术出发,更要由业务和管理手段驱动最终结果与优先级。
数据集与Agent:关系与分类
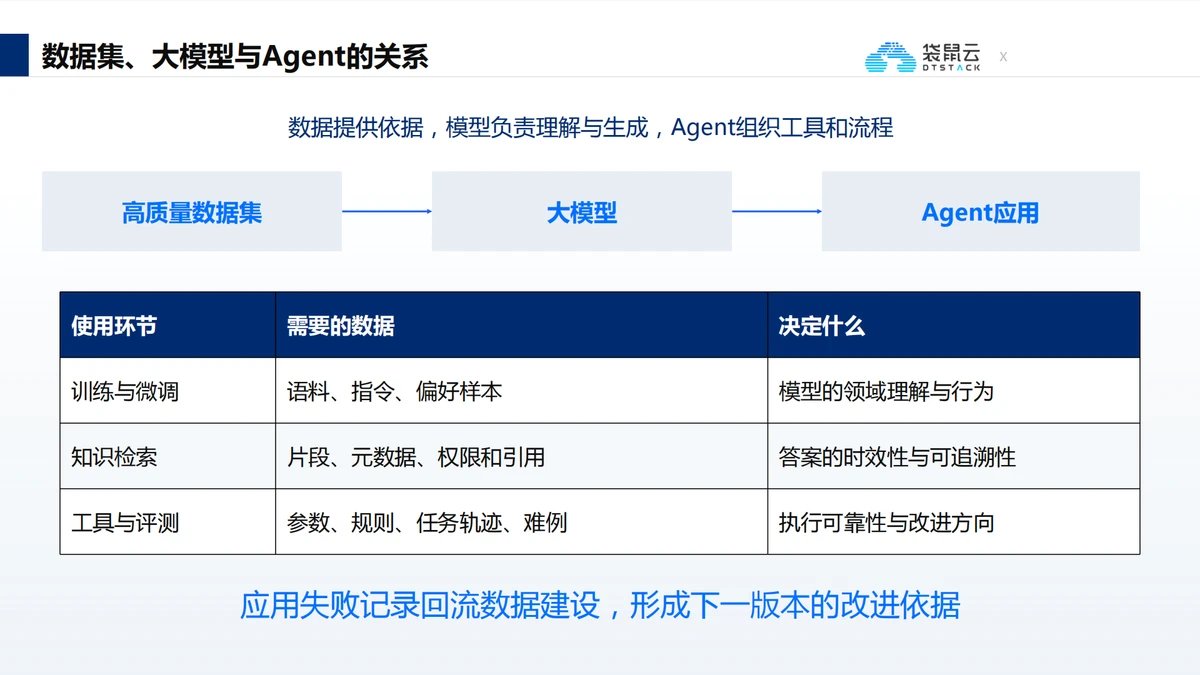
一方面,数据集可为大模型提供专业领域知识,使其成为行业专业模型;另一方面,数据集可构建知识图谱,作为大模型的外部增强能力,支撑Agent应用。因此数据集需具备训练微调、知识检索、供给与评测等能力。其发展经历了从通用语料、行业知识、多模态证据到任务轨迹的演进:从人人能理解的日常对话,到需要财务三大表等专业知识的行业问题,再到需要报销单、发票凭证等多模态证据共同支撑,最终训练中形成的任务轨迹也要留痕,生成新版本,用于反馈与追溯。
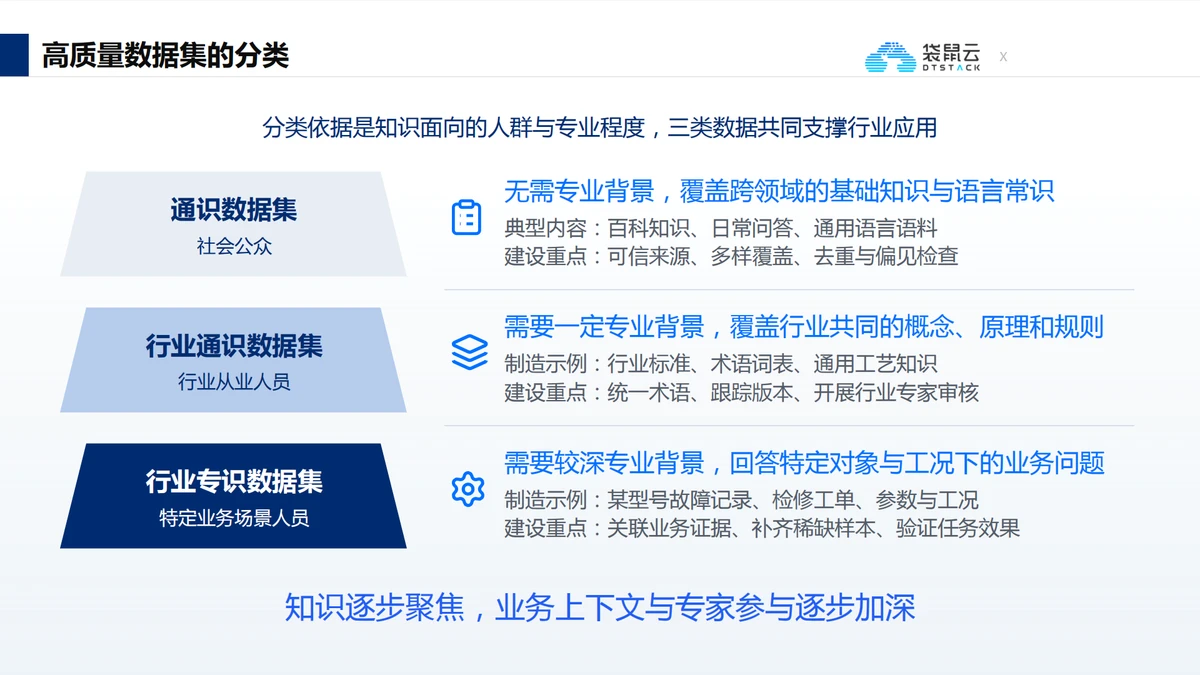
**高质量数据集可定义为:经过处理、可用于AI模型开发训练,并能提升模型性能的数据集合,与传统结构化数据相比带有明确的AI目的。**按用途可分为训练、检索、评测与任务轨迹;按模态涵盖结构化数据、文本、图片、音频、视频、时序等;按领域知识分为通识、行业通识与行业专识三类,其中行业专识数据集代表领域专家能力,以专家视角解决问题,而非简单问答对。
建设方案:六步流程与关键技术
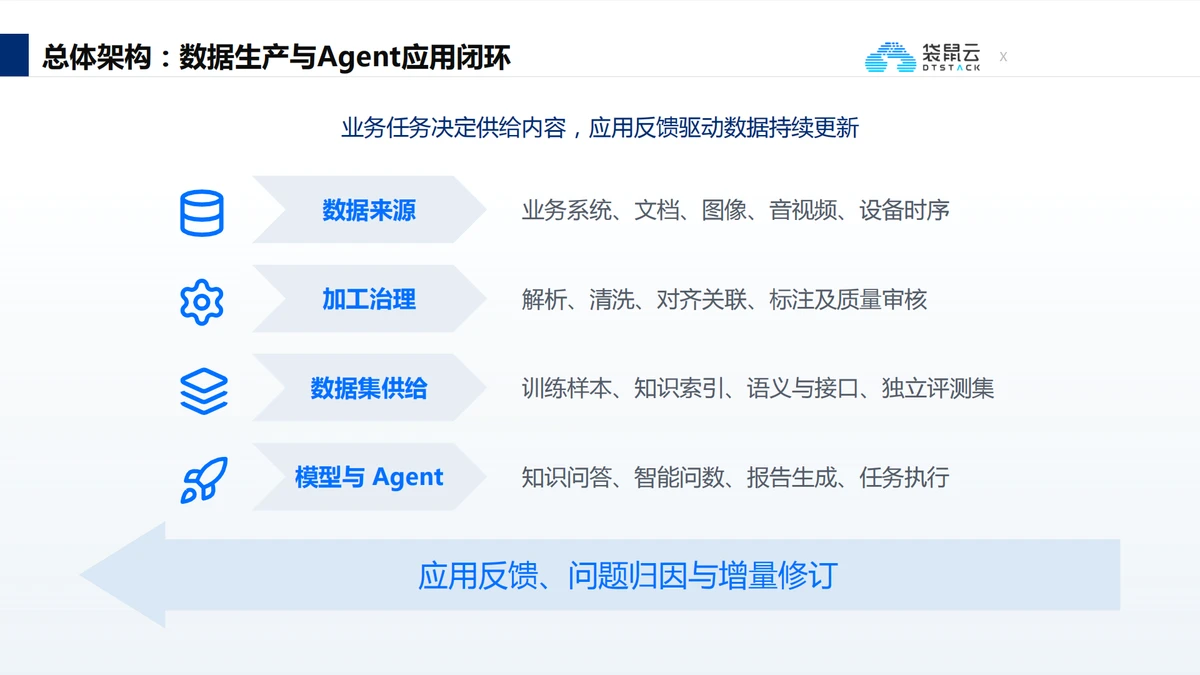
数据来源包括信息化系统、手工填报、设备IoT与时序数据以及音视频等,体量较结构化数据呈指数级增长。加工治理上,结构化数据可沿用传统数据治理方法论,非结构化与多模态数据则需借助算法算子与业务规则,完成打标、切片、特征提取并形成向量数据。
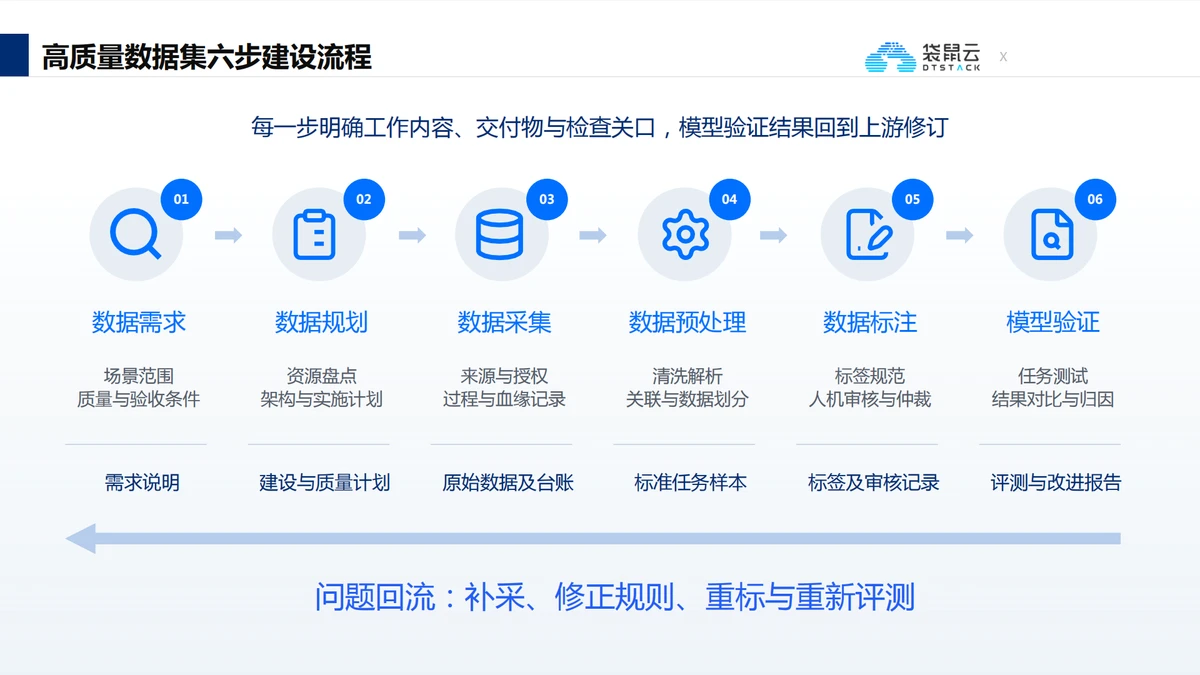
建设方式有两种:一是从数据出发,把现有多模态数据统一采集加工;二是面向业务场景或特定目标,如制造业订单驱动场景或金融行业场景。本次分享聚焦后者,流程分为数据需求、规划、采集、预处理、标注和模型验证六步。需求与规划阶段需明确使用场景、使用部门和要解决的问题,进而确定建设目标、涉及的业务系统和数据类型、验收标准及技术选型。采集预处理阶段,结构化数据通过数据库直连或接口获取,文档借助OCR切片分词,图片视频抽帧切片,音频借助ASR转写。标注阶段先定义通用规则与行业业务规则,例如轴承温度异常的阈值,在不同产线可能分别是60度和80度;再由机器预标,难标数据经人工修订、复核与仲裁,使数据可被人和机器共同识别。
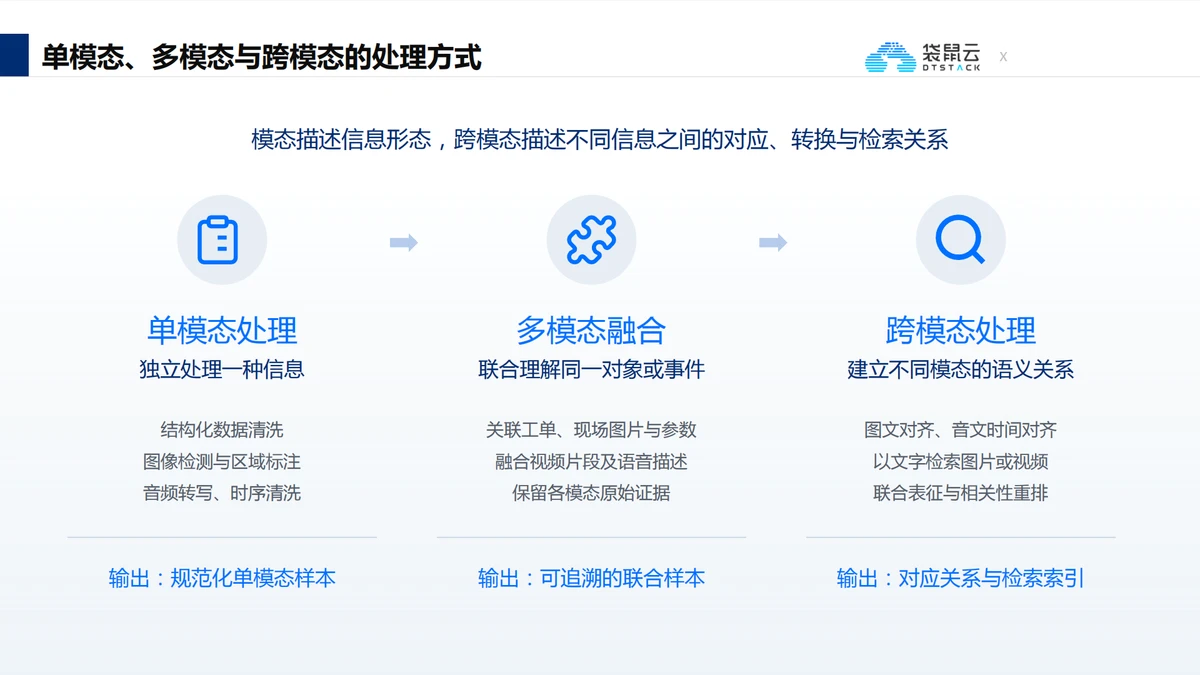
多模态处理上,单模态处理的是单一类型数据;多模态融合则因不同模态所需的技术栈、计算引擎乃至CPU、GPU资源不同,使技术与硬件架构随之改变;跨模态处理需先对齐时间、空间和版本,再通过Embedding提取并关联特征,经召回与重排优化,实现以文搜图、以图搜视频等。这些数据还可与本体建设结合,形成知识图谱,便于机器和Agent理解学习。
评价体系涵盖说明文档(来源、授权、版权、用途)、数据质量(完整性、准确性、一致性、有效性、时效性及取值范围等业务规则)和模型应用效果。该工程与数据治理类似,是"有头无尾"的:运行监控、归因修订、回归发布往复进行,并随业务变化持续做版本定义和数据对齐。
Agent应用实践:四个典型场景
制造场景中,从订单到交付(Order to Deliver)的全链路涉及CRM、ERP、PLM、APS、MES、QMS、WMS/WCS、TMS及售后系统,将这些系统、人工和设备数据汇聚到数据集后,由Agent拉通分析,产能与效率的提升便有迹可循。
科研场景中,将人所理解的专业规则与文献、波形、图纸等数据串联,自动生成研究报告并持续迭代版本。
经营分析场景中,某金融客户汇聚营销系统与线下门店等分散数据,聚焦用户行为背后的根因,由Agent完成分析,优化下一次投放策略。
项目复盘场景中,面向周期两到三年、涉及几十个部门上百人的工程项目,复盘报告由半年缩短为按月自动输出,并由事后前移至事前、事中。
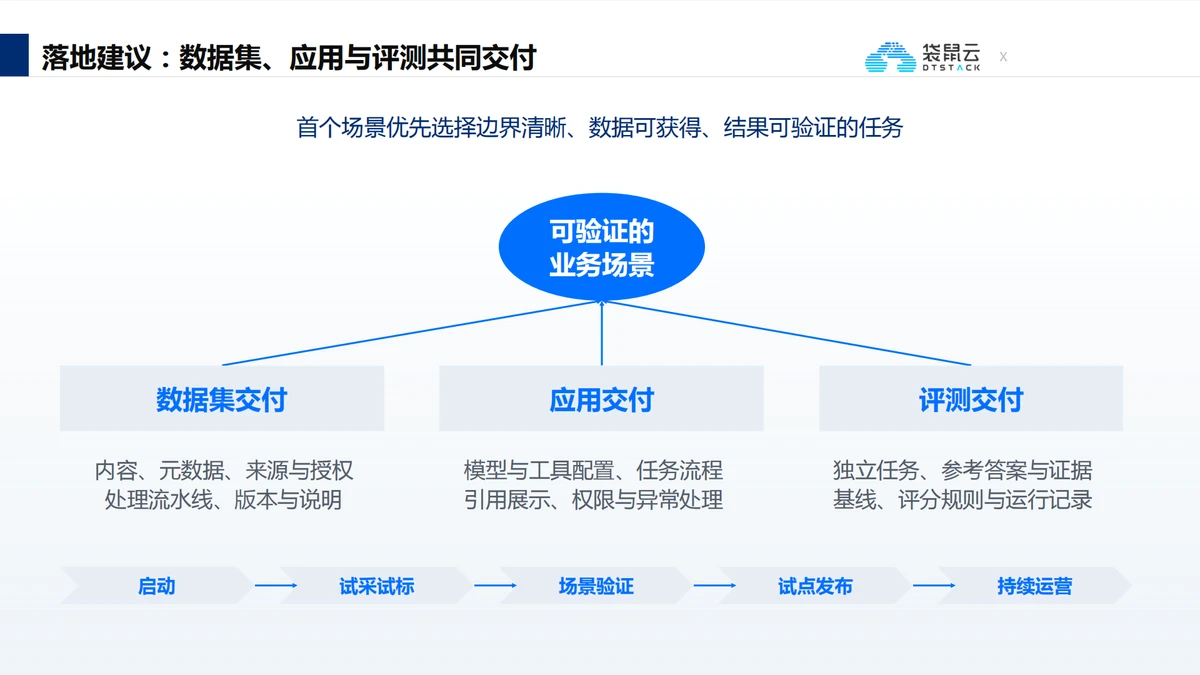
企业先确定可验证的细分业务场景,明确所需的业务数据与底层通用数据,交付数据集、可直接供业务人员使用的Agent应用,以及评测标准。
互动问答
问:上下文是给到模型的核心输入,它与各类数据是什么关系? 答:分阶段发展。第一阶段以知识库回答通识、行业与专家问题;第二阶段不同人、不同场景问同一问题,结果应有差异,这就需要上下文识别人和场景,也识别特定语境与业务场景,依靠高质量数据集构建垂类大模型和更准确的知识图谱。以财务Agent为例,从回答营收、同比环比,到不同角色得到不同结果与数据权限,再到不同产品线、事业部指标定义不同。这套语义是独立规则,指导数据集建设方向。
问:Agent体系下,传统通用数据中台的价值是降低了,还是变了形态? 答:高质量数据集建设有从数据出发和由场景驱动两个维度,目前多数客户选择后者,因为管理者能直接看到价值。纯做数据中台或治理项目,即便数据质量达到99.99%,也难以体现利润、营收或成本变化。头部企业自下而上先建底座再开发场景;中小企业希望三到六个月见效,由应用倒推是否需要中台,场景数据量小时,小型数据库或Agent自带工具即可。但从数据复用与价值迭代看,数据中台仍有必要,只是由结构化演变为多模态数据中台。
问:多Agent协作落地时,需要注意什么? 答:以制造客户为例,订单到交付可拆为订单预测、供应商画像、排产等多个Agent,订单预测准确率若超过90%,后续采购、生产和设备维护计划都会随之调整。要保证协同,一是数据建设在同一套平台上,规范、治理标准与指标口径统一;二是基于同一数据质量标准输出;三是采用统一的数据标准与语义本体体系,例如“客户”对营销是买方、对生产是发货方,统一建模才能保持结果一致。各Agent的业务流由专家提前规划,订单到交付是主线,其下分支各自产生个性化Agent。
问:复盘涉及人员多、周期长,数据是如何归集的? 答:客户有项目管理主系统,但仅靠它不足以支撑复盘,立项、招采、验收、付款等环节还涉及外部机构系统和大量Word、PDF线下文件。客户对各节点有明确的内部政策要求,这些被作为语义或知识本体融入Agent,实现事前、事中分析。数据汇聚在项目执行过程中或之前已基本搭好,既有自动获取,也有人工上传;利用历史数据定义本体、模型与知识图谱后,新项目即可按流程预警。上层Agent因各企业流程不同以定制为主,底层数据集建设则有通用平台和产品支撑。
